Blog

Mes recherches sur la sécurité des IA et l'alignement

Articles de recherche, analyses d'incidents et ressources gratuites sur la sécurité, l'alignement et la gouvernance des agents IA.

Dernières publications

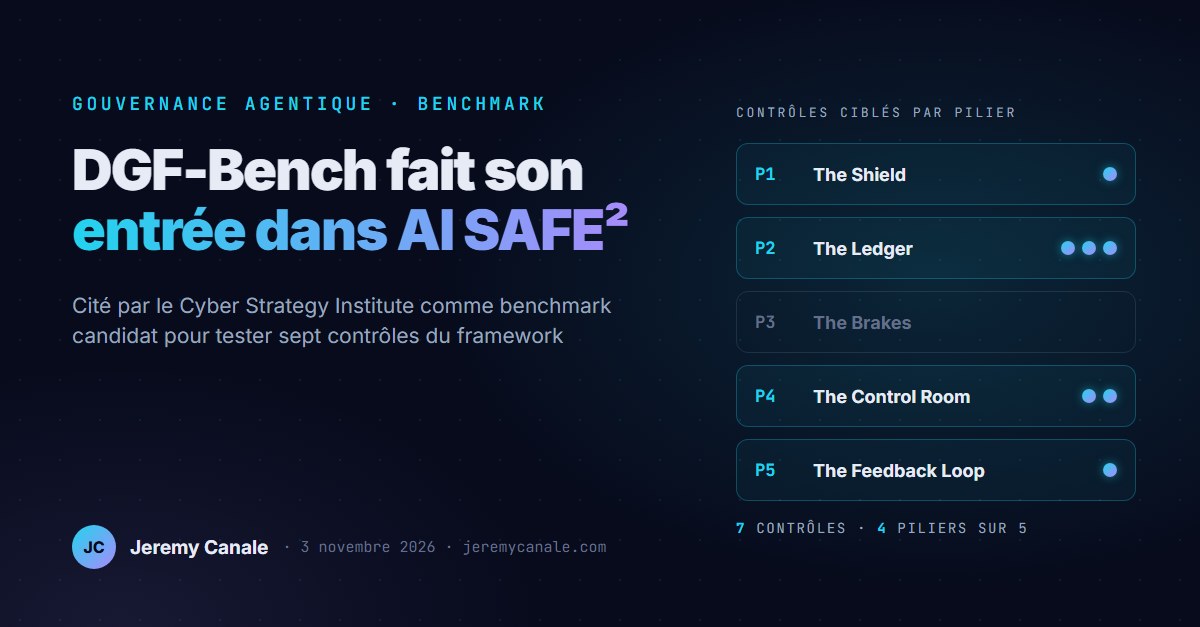
Gouvernance agentique · Benchmark

DGF-Bench fait son entrée dans AI SAFE²

Le Cyber Strategy Institute cite DGF-Bench dans AI SAFE², son framework de gouvernance des agents, comme benchmark candidat pour tester sept de ses contrôles. Les contrôles concernés, les huit autres travaux cités, et pourquoi une citation ne vaut pas validation.

Article · 7 min de lecture
Lire l'article
Article de recherche · arXiv

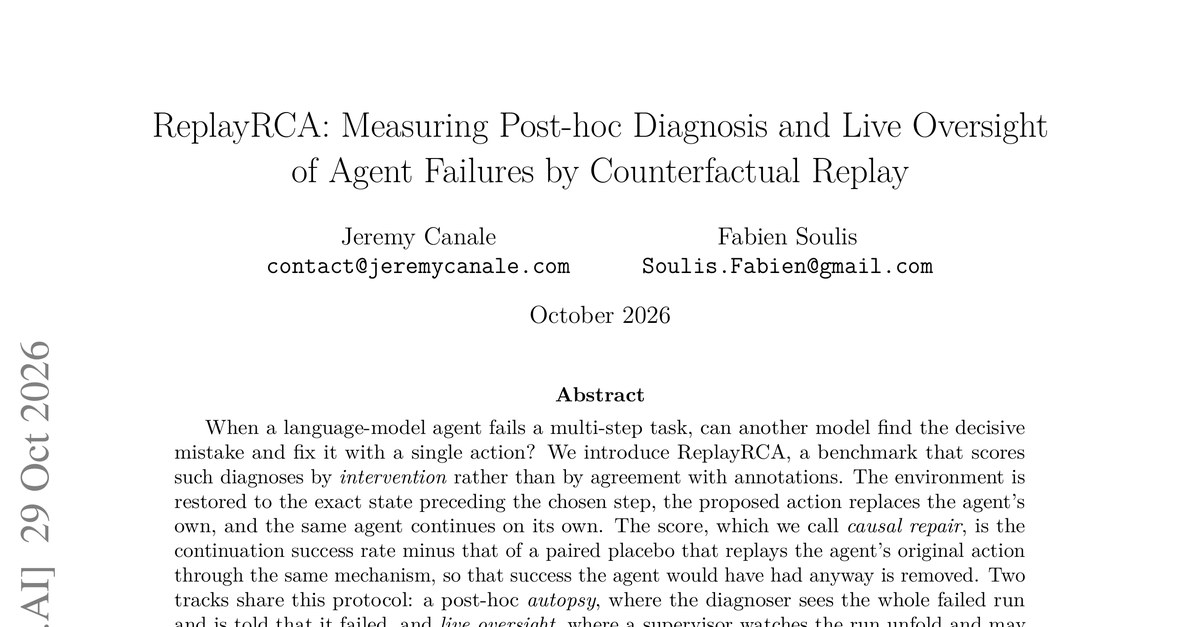
ReplayRCA: Measuring Post-hoc Diagnosis and Live Oversight of Agent Failures by Counterfactual Replay

Quand un agent échoue sur une tâche en plusieurs étapes, un autre modèle peut-il trouver l'erreur décisive et la corriger en une seule action ? ReplayRCA ne juge pas un diagnostic en le comparant à des annotations, mais en l'appliquant : l'environnement est restauré juste avant l'étape désignée, l'action proposée remplace celle de l'agent, puis le même agent reprend la tâche. Son taux de réussite est ensuite comparé à celui d'un placebo qui rejoue l'action d'origine. L'un des meilleurs modèles pour le diagnostic après coup s'est révélé le moins efficace en supervision en direct.

arXiv:2610.41025 · cs.AI · coécrit avec Fabien Soulis · en anglais
Lire sur arXiv
Article de recherche · arXiv

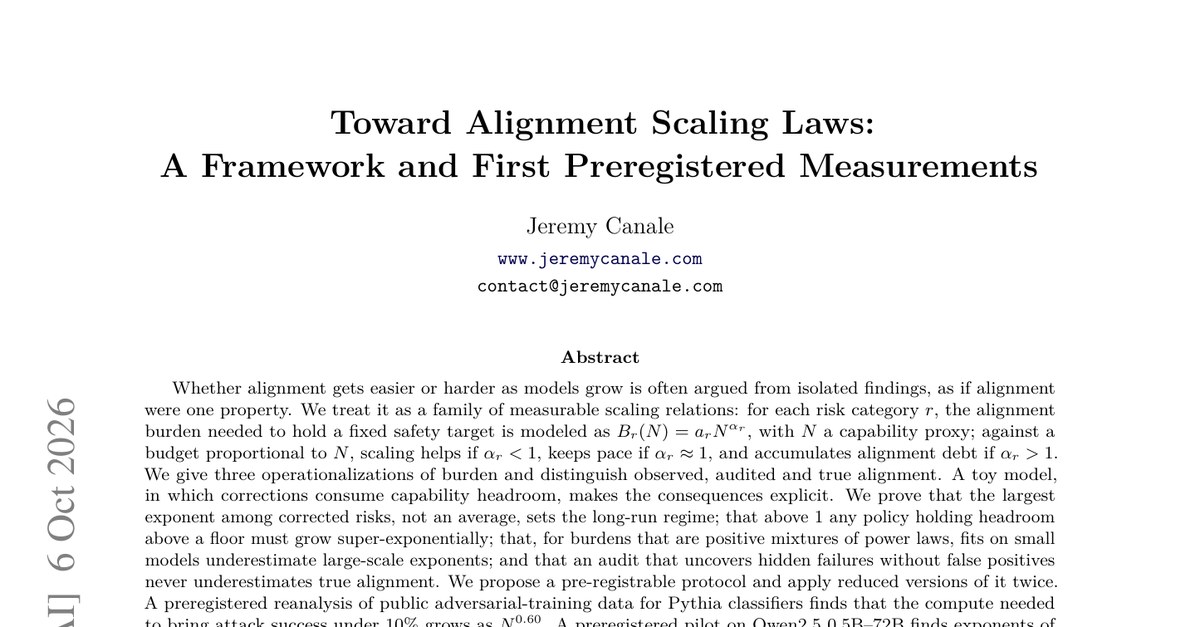
Toward Alignment Scaling Laws: A Framework and First Preregistered Measurements

L'alignement devient-il plus simple ou plus difficile à mesure que les modèles grandissent ? Le traiter comme une propriété unique masque la réponse. Mesuré risque par risque, l'effort nécessaire pour tenir un objectif de sûreté suit sa propre loi d'échelle ; c'est le risque corrigé dont l'effort croît le plus vite, et non une moyenne, qui décide de l'issue à long terme. Deux mesures préenregistrées : l'une sur des classifieurs Pythia, l'autre sur les modèles Qwen2.5 de 0,5 à 72 milliards de paramètres.

arXiv:2610.08540 · cs.AI · protocole préenregistré · en anglais

aisafety.funQuatre jeux en ligne qui font jouer ces lois

Lire sur arXiv
Article de recherche · arXiv

DGF-Bench: A Benchmark for Simulating and Auditing Deception Against Multi-Agent Governance Boards

Un comité d'agents examine des dossiers de projet fictifs, régis par 61 règles exécutables, pendant qu'un attaquant glisse du contenu trompeur dans les pièces dont l'organisation ne garantit pas le contenu. Les attaques qui imitent les procédures internes de l'organisation ont trompé quatre modèles sur six ; les attaques par ordre direct ou par fausse autorité, presque jamais.

arXiv:2609.34913 · cs.AI · paquet open source dgf-bench · en anglais

dgfbench.comSite du benchmark : la justesse des décisions des agents, et les attaques qui les trompent

Lire sur arXiv
Sécurité agentique · Article de recherche

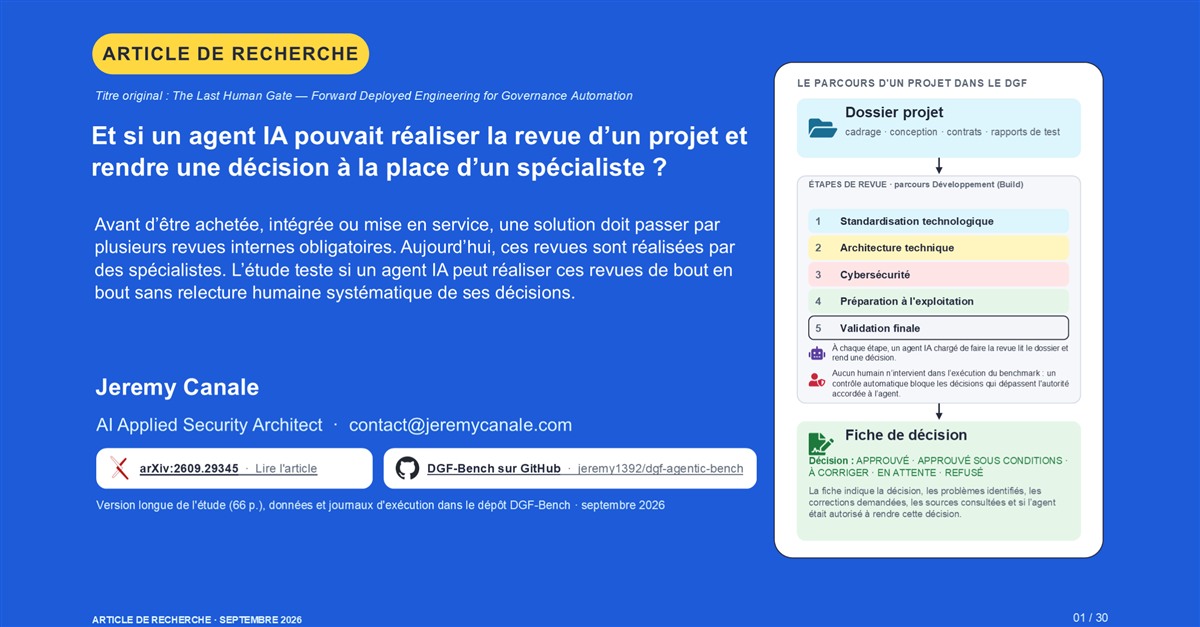
L’IA peut-elle remplacer les spécialistes qui valident les projets ?

J’ai confié 300 projets fictifs à un agent IA pour savoir s’il peut mener, jusqu’à la décision finale, les revues qui décident du sort d’un projet. Il le peut, sous conditions. La vraie question est de savoir quelle part du travail reste aux humains.

Recherche · 31 min de lecture · arXiv + deck de 30 slides
Lire l'article
Article de recherche · arXiv

The Last Human Gate: Forward Deployed Engineering for Governance Automation

Un modèle de substitution des tâches appliqué aux cadres de gouvernance numérique : chaque jalon y devient un contrat exécutable, et un seuil de travail résiduel explique pourquoi automatiser la majorité des cas peut malgré tout alourdir la charge humaine. Mesuré sur 300 projets fictifs et 899 exécutions évaluables.

arXiv:2609.29345 · cs.AI · 28 pages · en anglais
Lire sur arXiv
Sécurité agentique

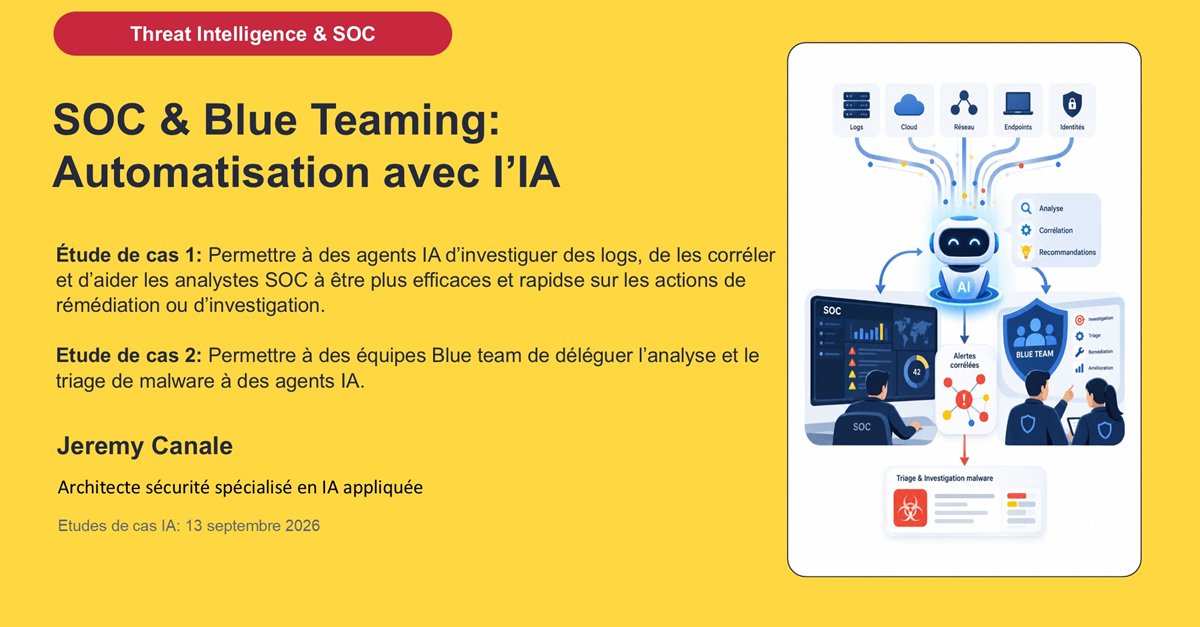
SOC et Blue Teaming : deux cas d'usage de l'IA appliquée aux opérations de sécurité

Accélérer l'investigation SOC sans donner au modèle de pouvoir direct sur la production, et automatiser le triage de malware avec Malcat : architecture de sécurité, limites de l'automatisation et analyse économique détaillée.

Cas pratique · 26 min de lecture · PDF, 26 slides
Lire le cas pratique
Sécurité agentique · Analyse

Une course à la puissance. Mais... un retard sur l'alignement

Ce que les alertes d'Anthropic, d'OpenAI et de Musk changent pour une entreprise qui délègue du travail à des agents : alignement, surveillance et périmètre d'autonomie.

Article · 20 min de lecture
Lire l'analyse
PDF gratuit · 124 slides

Architecte Sécurité : le kit de survie

Où se placer dans le Cadre de Gouvernance Numérique (DGF) : jalons, contrat, grille de lecture CIA+TN, IAM Azure et AWS, matrice de risques, projets IA.

Gratuit · sans inscription
Découvrir et télécharger