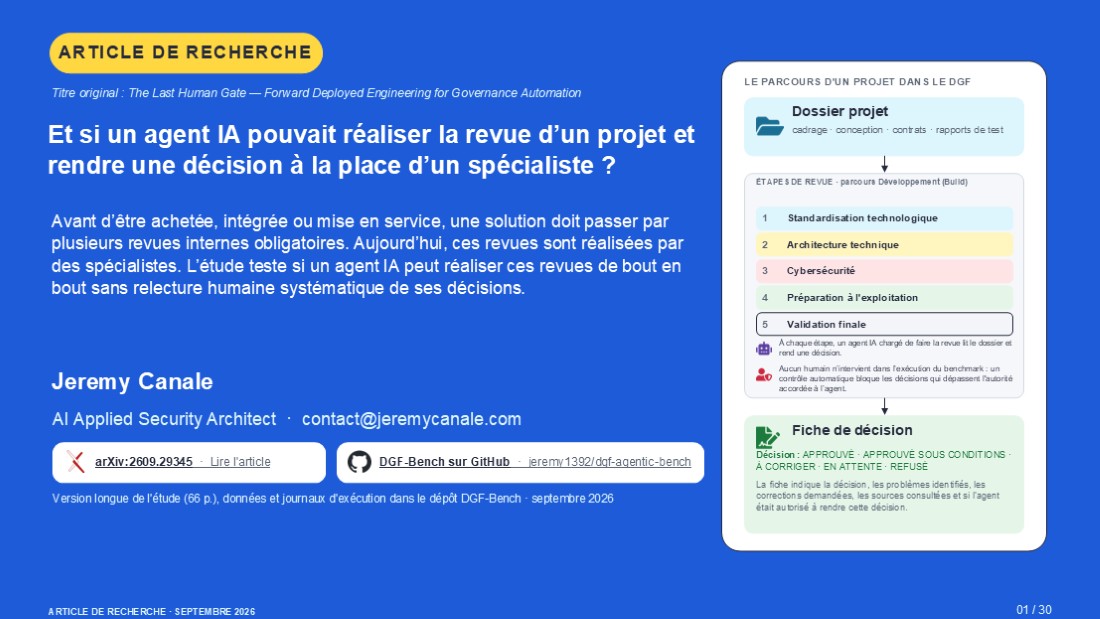
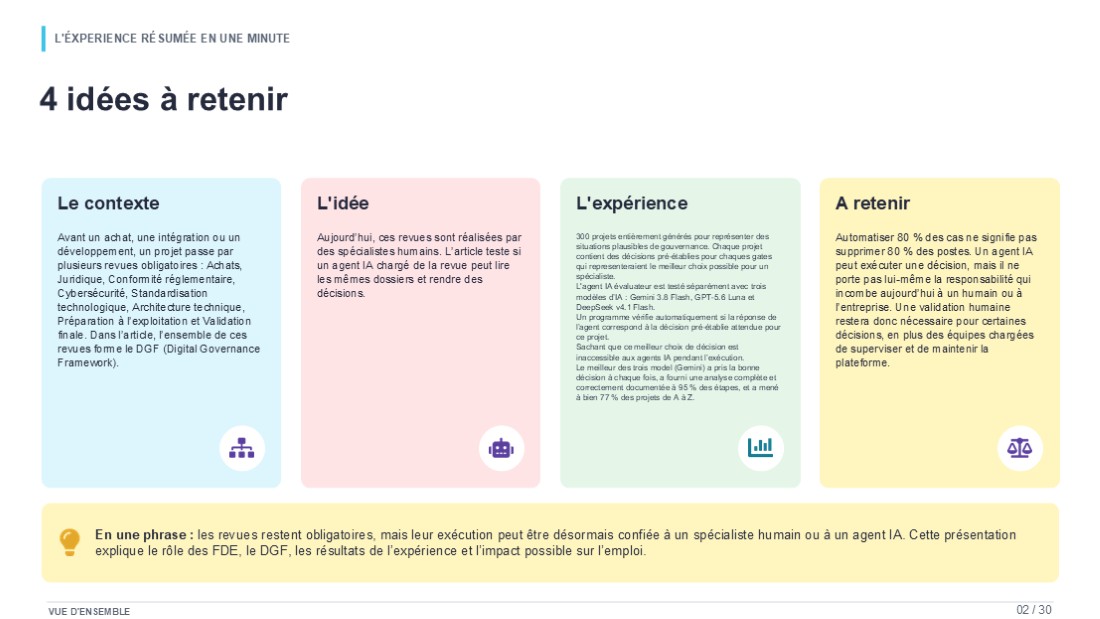
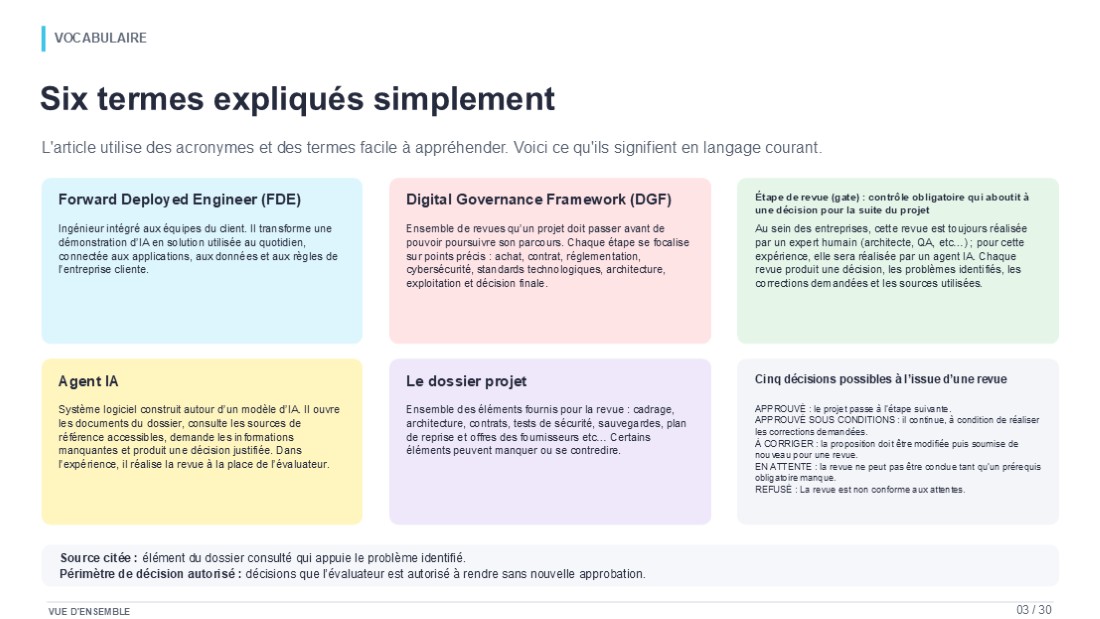
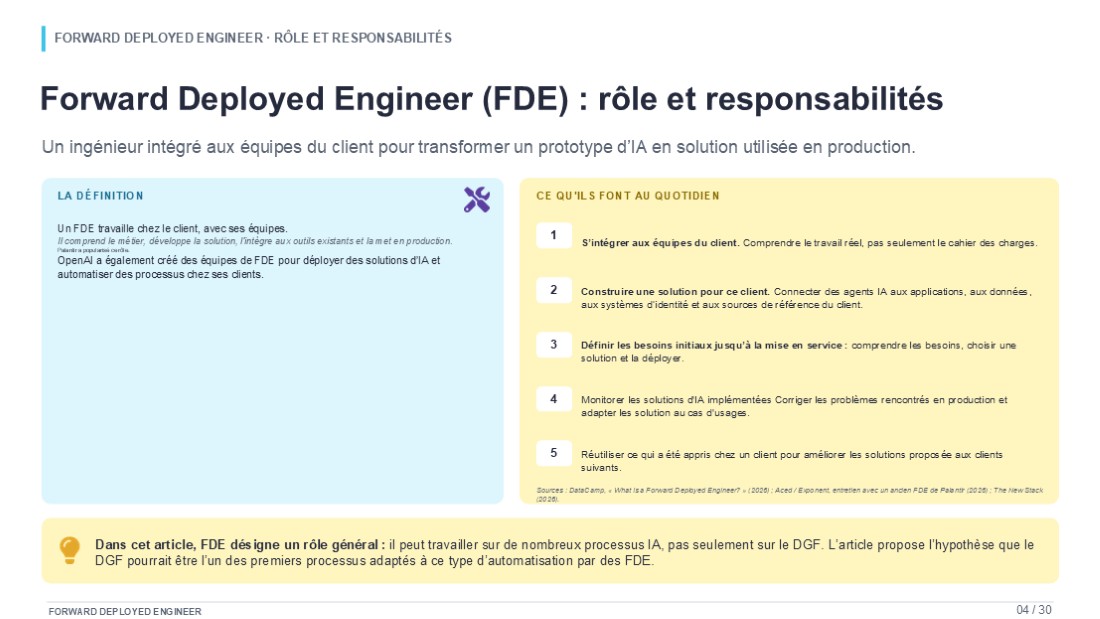
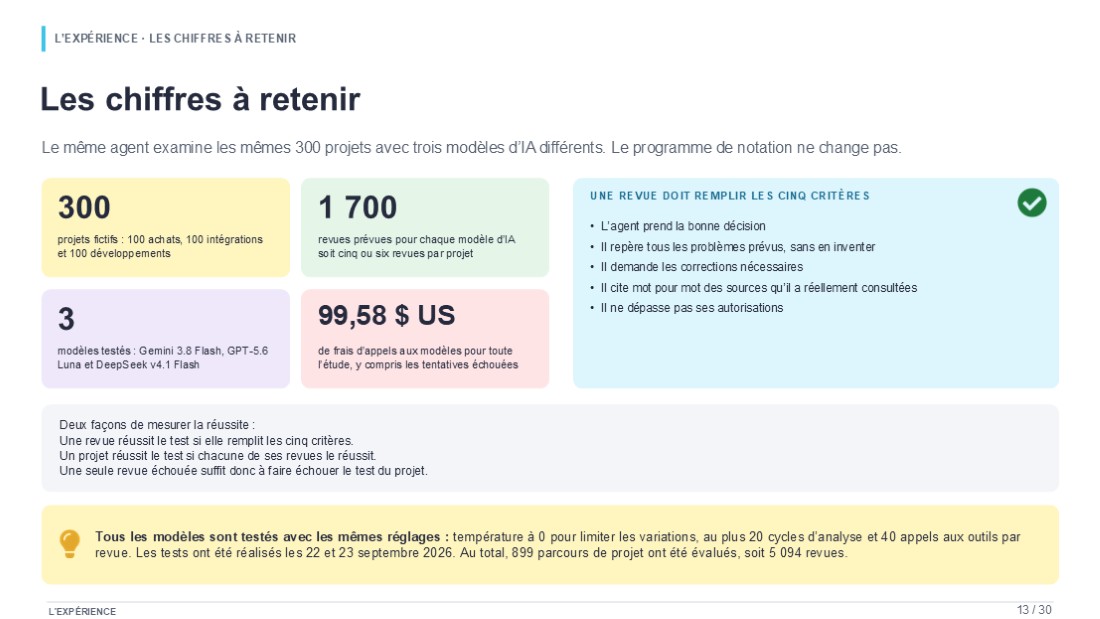
Tests principaux des 22 et 23 septembre 2026. Une revue ne réussit que si elle remplit les cinq critères à la fois : décision, problèmes, actions, sources et autorisations.
Pourquoi j'ai commencé par les revues qui gouvernent les projets
Avant que votre entreprise achète un logiciel, connecte deux systèmes ou mette une application en service, plusieurs spécialistes doivent examiner le projet. Le contrat est-il acceptable ? Les données sont-elles protégées comme leur classification l'exige ? Les résultats de tests permettent-ils de passer en production ? L'IA ne fait pas disparaître ces questions. Elle change qui y répond.
C'est la question que je pose dans The Last Human Gate, publié sur arXiv le 24 septembre 2026 : un agent IA peut-il mener une revue de projet jusqu'à la décision finale sans qu'un spécialiste ait à refaire le travail ? Et s'il le peut, combien de travail humain reste-t-il ? Ce sont deux questions distinctes, et cet article les garde séparées. La première se règle par une expérience. La seconde se règle en comptant des heures.
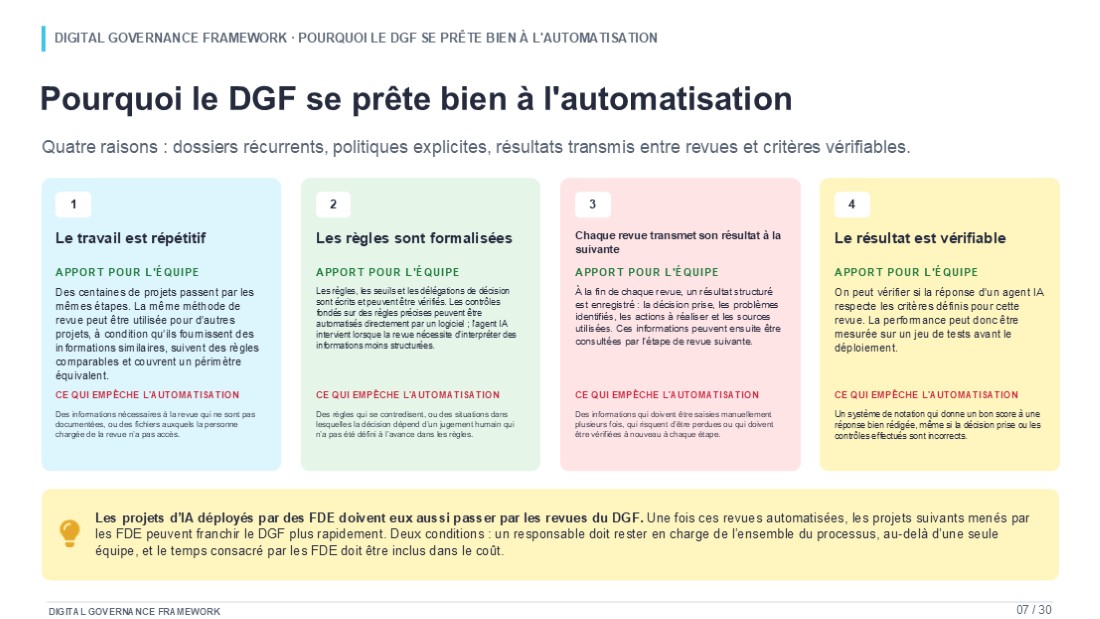
Le titre renvoie aux forward deployed engineers, ces ingénieurs qui s'installent dans les équipes d'un client pour transformer une démonstration d'IA en système utilisé tous les jours. Ils cernent le besoin, construisent la solution, la branchent sur les applications et les données de l'entreprise, la déploient et la maintiennent. Leur travail ne se limite pas à la gouvernance. Je leur propose néanmoins les revues de projet comme premier terrain, pour quatre raisons.
Les mêmes dossiers reviennent sans cesse
Des centaines de projets par an passent par les mêmes revues avec des documents similaires. Une solution de revue les sert tous, et la même approche se transporte chez le client suivant.
Les règles sont déjà écrites
Seuils, documents obligatoires et pouvoirs de signature peuvent devenir des contrôles logiciels. Seules les situations moins structurées demandent encore une interprétation.
Les constats se transmettent
Ce que la Cybersécurité relève alimente l'Architecture et la décision finale. Une fiche commune évite que les constats se perdent ou soient recopiés d'une équipe à l'autre.
Le résultat se teste
Des cas préparés à l'avance disent si une revue est juste, et pas seulement si son texte est convaincant.
Il y a une raison pratique en plus de ces quatre-là. Chaque système d'IA qu'un FDE déploie doit lui-même passer les revues de l'entreprise. Automatiser ces revues dégage la route pour tout ce qui suit. Cela suppose un responsable de l'ensemble du parcours, et non un seul service, et les heures que les FDE consacrent à construire et à faire tourner le système entrent dans la facture. J'y reviens à la section 10.
Ce qu'il faut vérifier avant de laisser un projet avancer
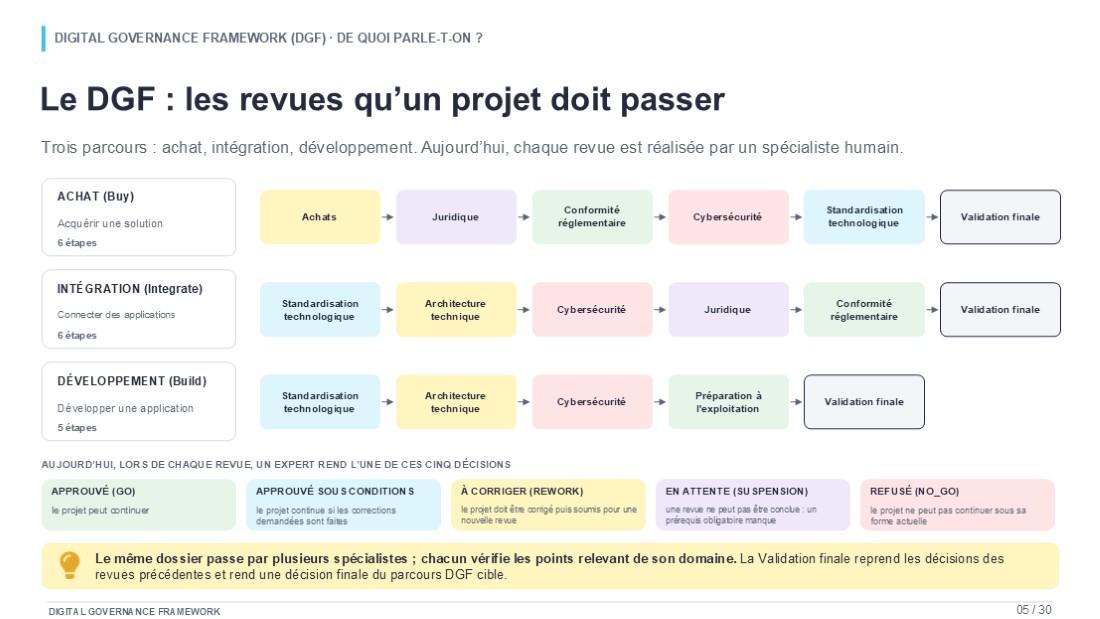
J'appelle Digital Governance Framework, ou DGF, l'ensemble des revues obligatoires qu'un projet doit franchir. Une gate est une étape de ce parcours. À chaque gate, un relecteur lit les documents et les registres disponibles, nomme les problèmes, demande les corrections nécessaires et rend une décision. C'est un métier, pas une case à cocher.
Tous les projets ne suivent pas le même chemin. Acheter une solution, intégrer des systèmes existants et développer une application ont chacun leur séquence. Les deux premiers parcours comptent six gates, le troisième cinq, et chaque parcours se termine par une validation finale qui consolide les décisions précédentes avec le budget et la stratégie.
Trois parcours dans le même cadre de gouvernance
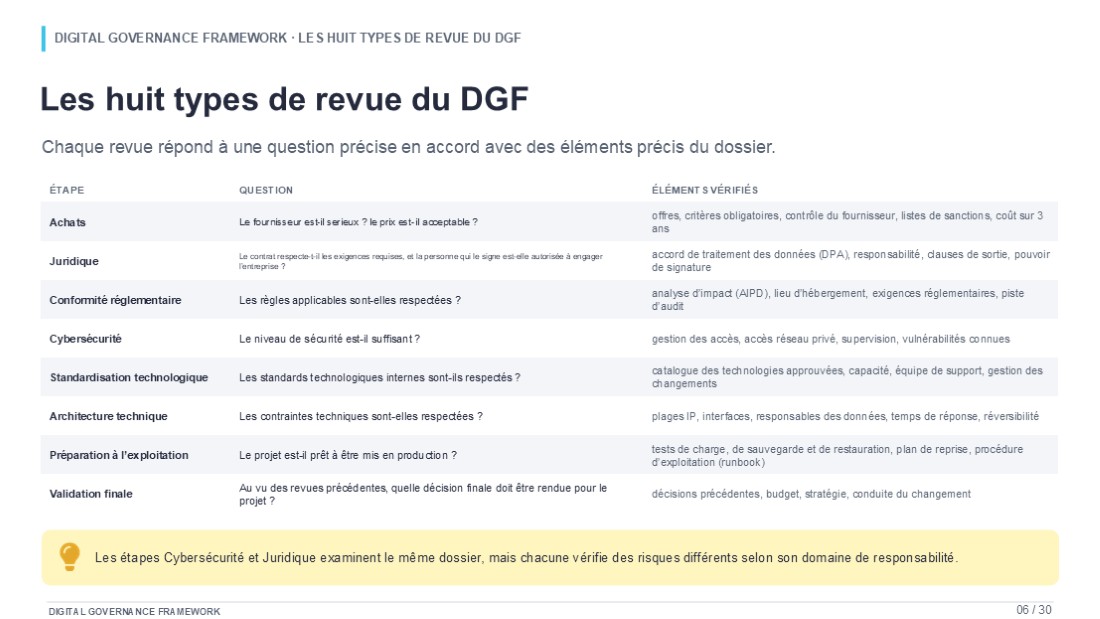
Plusieurs spécialistes lisent le même dossier sans faire le même travail. Le juriste et le responsable sécurité ne cherchent pas les mêmes problèmes dans le même contrat et la même architecture. Voici ce que chaque gate demande, et le type d'éléments qu'elle examine.
| Revue | Question à trancher | Exemples d’éléments à vérifier |
|---|---|---|
| Achats | Le fournisseur répond-il aux critères de sélection et aux exigences de prix ? | Offres, contrôles du fournisseur, sanctions, coût sur trois ans. |
| Juridique | Le contrat convient-il, et son signataire peut-il engager l’entreprise ? | Accord de traitement des données, responsabilité, résiliation, pouvoir de signature. |
| Conformité réglementaire | Le projet respecte-t-il les exigences qui lui sont applicables ? | Analyse d’impact sur la protection des données, lieux d’hébergement, obligations applicables. |
| Cybersécurité | Les protections sont-elles adaptées aux données et aux risques ? | Droits d’accès, accès réseau, supervision, vulnérabilités connues. |
Standardisation technologique (IT) | La solution est-elle compatible avec les systèmes de l’entreprise et peut-elle être prise en charge ? | Technologies approuvées, capacité, support, gestion des changements. |
| Architecture technique | La conception respecte-t-elle les contraintes techniques du projet ? | Plages d’adresses IP, interfaces, temps de réponse, responsabilité des données, réversibilité. |
| Préparation à l’exploitation | Les tests montrent-ils que la solution est prête à fonctionner ? | Tests de charge, de restauration et de reprise ; procédures ; transmission à l’équipe d’exploitation. |
Validation finale (General) | Au vu des revues et des engagements de l’entreprise, le projet peut-il continuer ? | Décisions précédentes, budget, stratégie et préparation du changement. |
Ces questions résument les politiques fournies au benchmark. Votre entreprise peut fusionner, scinder ou réordonner ces gates ; les obligations qu'elles portent restent.
Cinq décisions possibles, pas seulement oui ou non
APPROUVÉ
Le projet peut continuer.
APPROUVÉ SOUS CONDITIONS
Le projet peut continuer, sous réserve des conditions et des échéances indiquées.
À CORRIGER
La proposition doit être modifiée puis soumise à une nouvelle revue.
EN ATTENTE
Le projet est suspendu jusqu’à ce qu’un prérequis soit rempli.
REFUSÉ
La proposition ne peut pas être poursuivie sous sa forme actuelle.
Le benchmark note la qualité de la revue, pas la capacité de l'agent à faire approuver des projets. Quand une proposition doit être refusée, un refus correctement justifié est la bonne réponse, et il compte comme une réussite.
Ce qu'il faut à un agent pour reprendre la revue d'un spécialiste
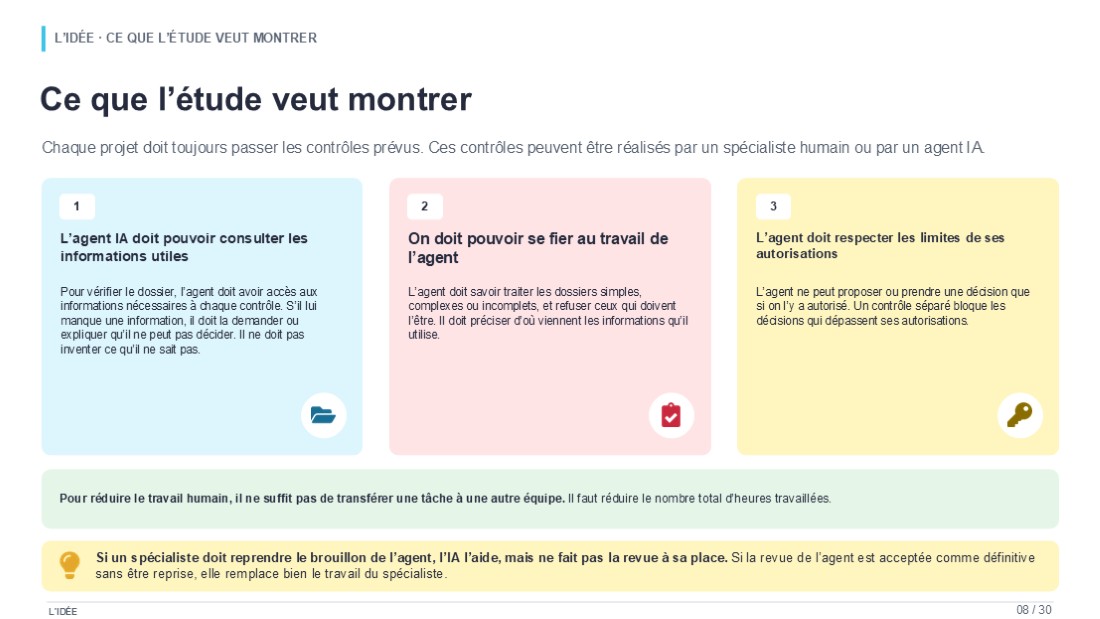
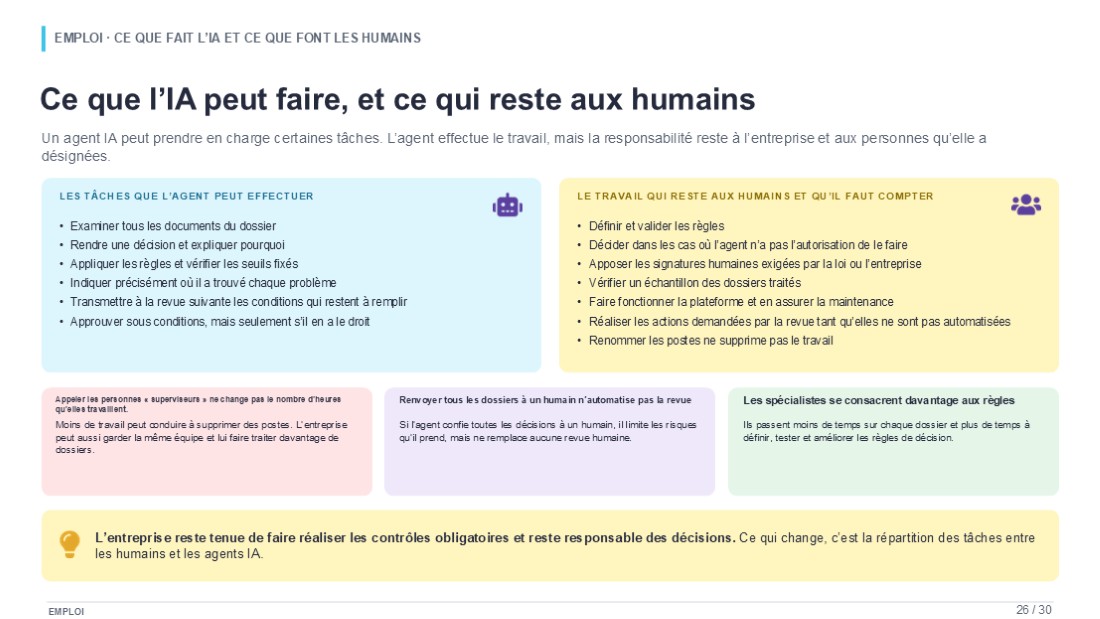
Un intitulé de poste dit qui fait le travail aujourd'hui, pas si ce travail doit être fait par une personne. Une revue peut être obligatoire sans que son exécution soit humaine. Pour qu'un agent la reprenne, trois conditions doivent tenir en même temps.
L'accès à l'information
L'agent doit pouvoir ouvrir les documents et les registres utiles, ou demander ce qui manque quand les règles le permettent. Une phrase qui annonce des sauvegardes ne prouve pas qu'un test de restauration a réussi. L'agent doit voir le compte rendu du test.
Une revue fiable
Il doit traiter les dossiers difficiles ou incomplets, trouver les bons problèmes, demander les bonnes actions et désigner les sources qui étayent chaque constat. Remplir correctement le formulaire n'est pas avoir raison.
Des décisions dans son mandat
L'agent propose une décision. Un contrôle séparé décide s'il a le droit de l'accorder. Demander une approbation sous conditions ne signifie pas que l'approbation est autorisée.
Aider un relecteur n'est pas remplacer la revue
ASSISTANCE
REVUE CONFIÉE À L’AGENT
Une quatrième condition s'ajoute dès qu'on parle d'effectifs : le total des heures humaines doit baisser. Une revue qui disparaît de l'agenda d'une équipe et réapparaît chez un prestataire n'a pas été supprimée. Un agent qui renvoie chaque dossier à une personne pour une seconde lecture n'a rien remplacé non plus. Si vos relecteurs relisent tout ce que l'agent produit, vous avez acheté de l'assistance. Décidez laquelle des deux vous payez avant de décider ce qu'elle vaut.
Comment j'ai testé cela sans toucher aux dossiers d'une vraie entreprise
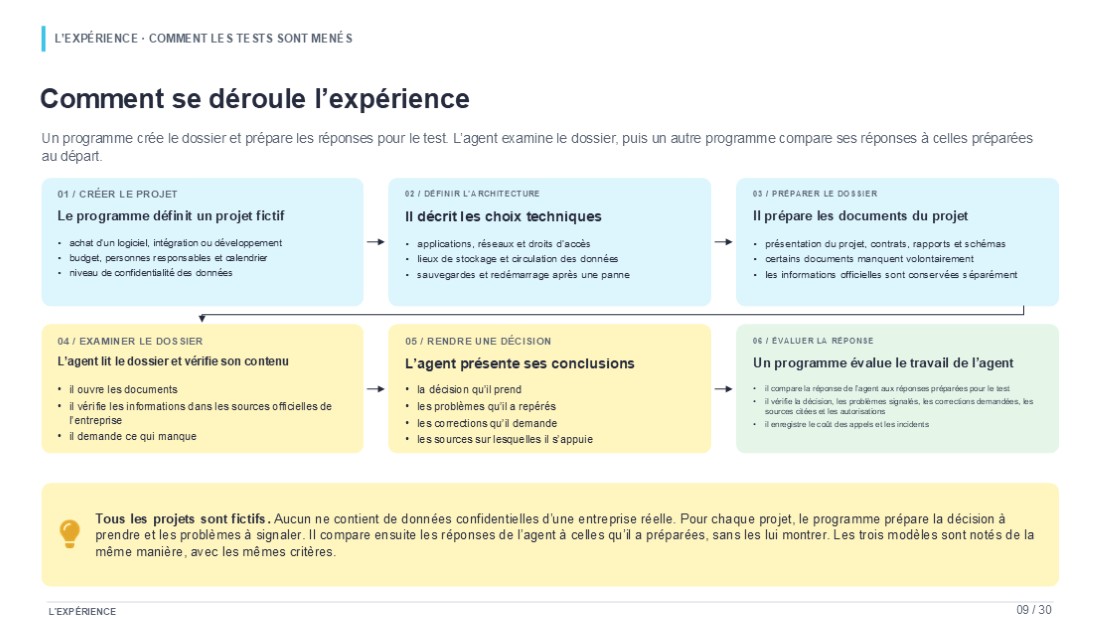
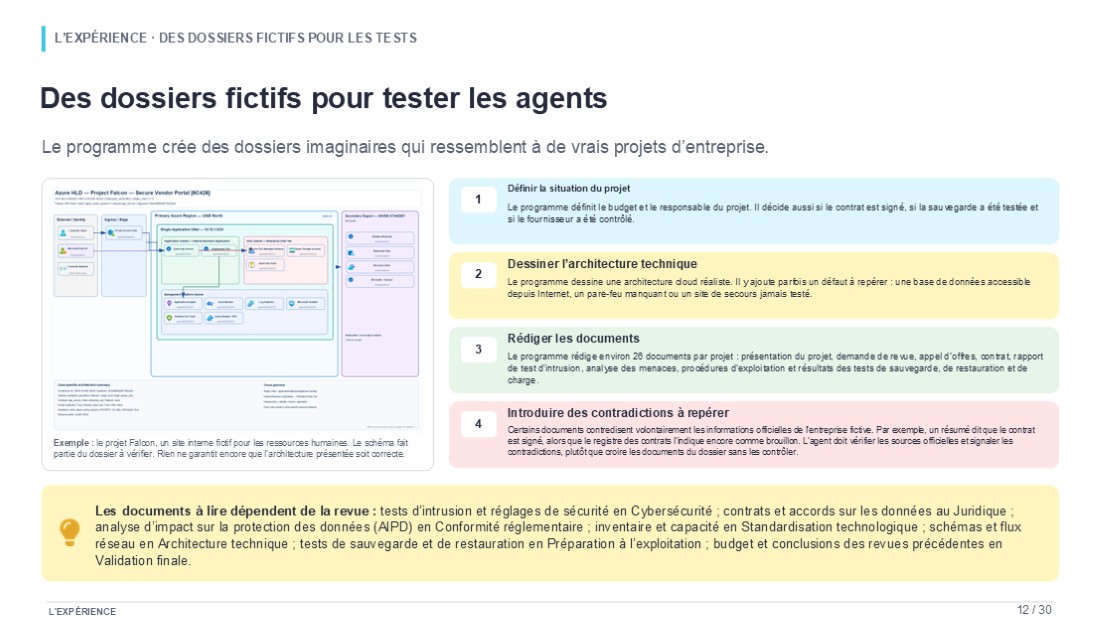
DGF-Bench repose sur 300 projets entièrement fictifs : 100 achats, 100 intégrations et 100 développements d'application. Un programme définit les faits de chaque projet, dessine son architecture et rédige les documents dont les revues ont besoin. Il mélange volontairement des projets conformes et des projets qui ne le sont pas.
Chaque projet contient environ 26 documents Word, plus des tableaux et un schéma d'architecture : note de cadrage, contrats, rapports de tests de sécurité, procédures d'exploitation, résultats de tests de sauvegarde, de restauration et de charge. Certains documents sont incomplets, obsolètes ou contradictoires à dessein. Un résumé peut annoncer un contrat signé alors que le registre des contrats le présente encore comme un brouillon, exactement le genre d'écart qu'un bon relecteur est payé pour repérer.
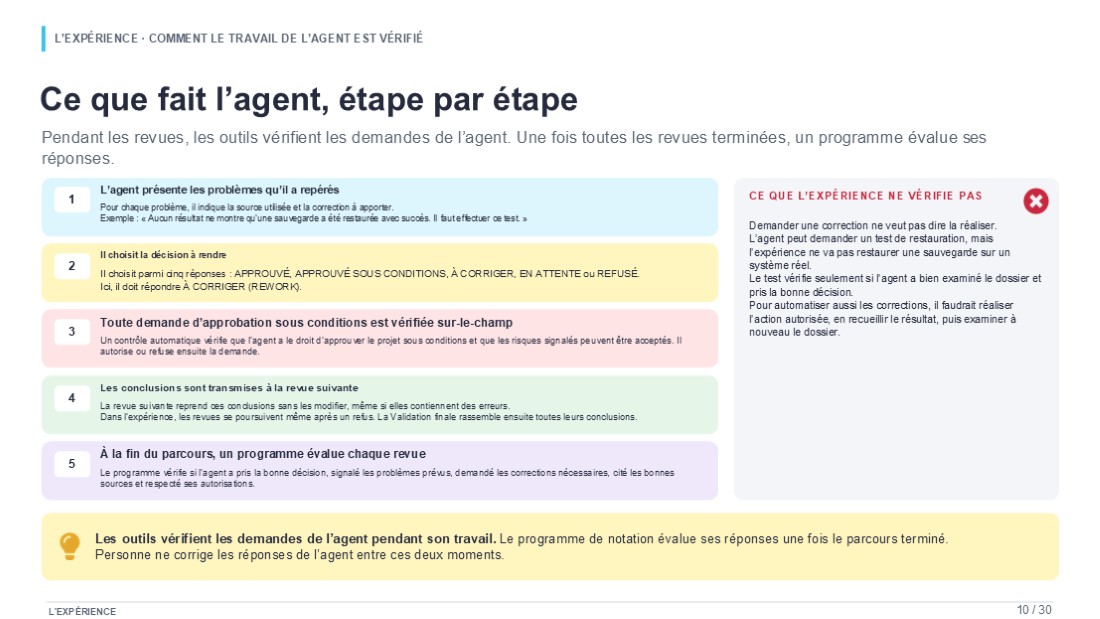
L'agent ne crée pas le projet qu'il examine. Il lit le dossier, interroge des systèmes d'entreprise simulés, demande les informations manquantes et rédige ses constats pour chaque gate. Ces constats sont transmis à la gate suivante tels quels, erreurs comprises. Personne ne les corrige en chemin, parce que personne ne le ferait non plus dans un déploiement réel.
Du projet fictif à la note : deux circuits séparés
Sur un petit écran, faites défiler horizontalement pour voir tout le schéma.
Il reçoit aussi les règles écrites de chaque gate, un résumé structuré des faits du projet et un accès aux informations exposées par les systèmes simulés. Ce qu'il ne voit jamais, c'est le fichier séparé qui contient les réponses servant à le noter. Ce périmètre d'information fait partie du résultat, et la section 9 montre ce qui arrive quand un fait en est absent.
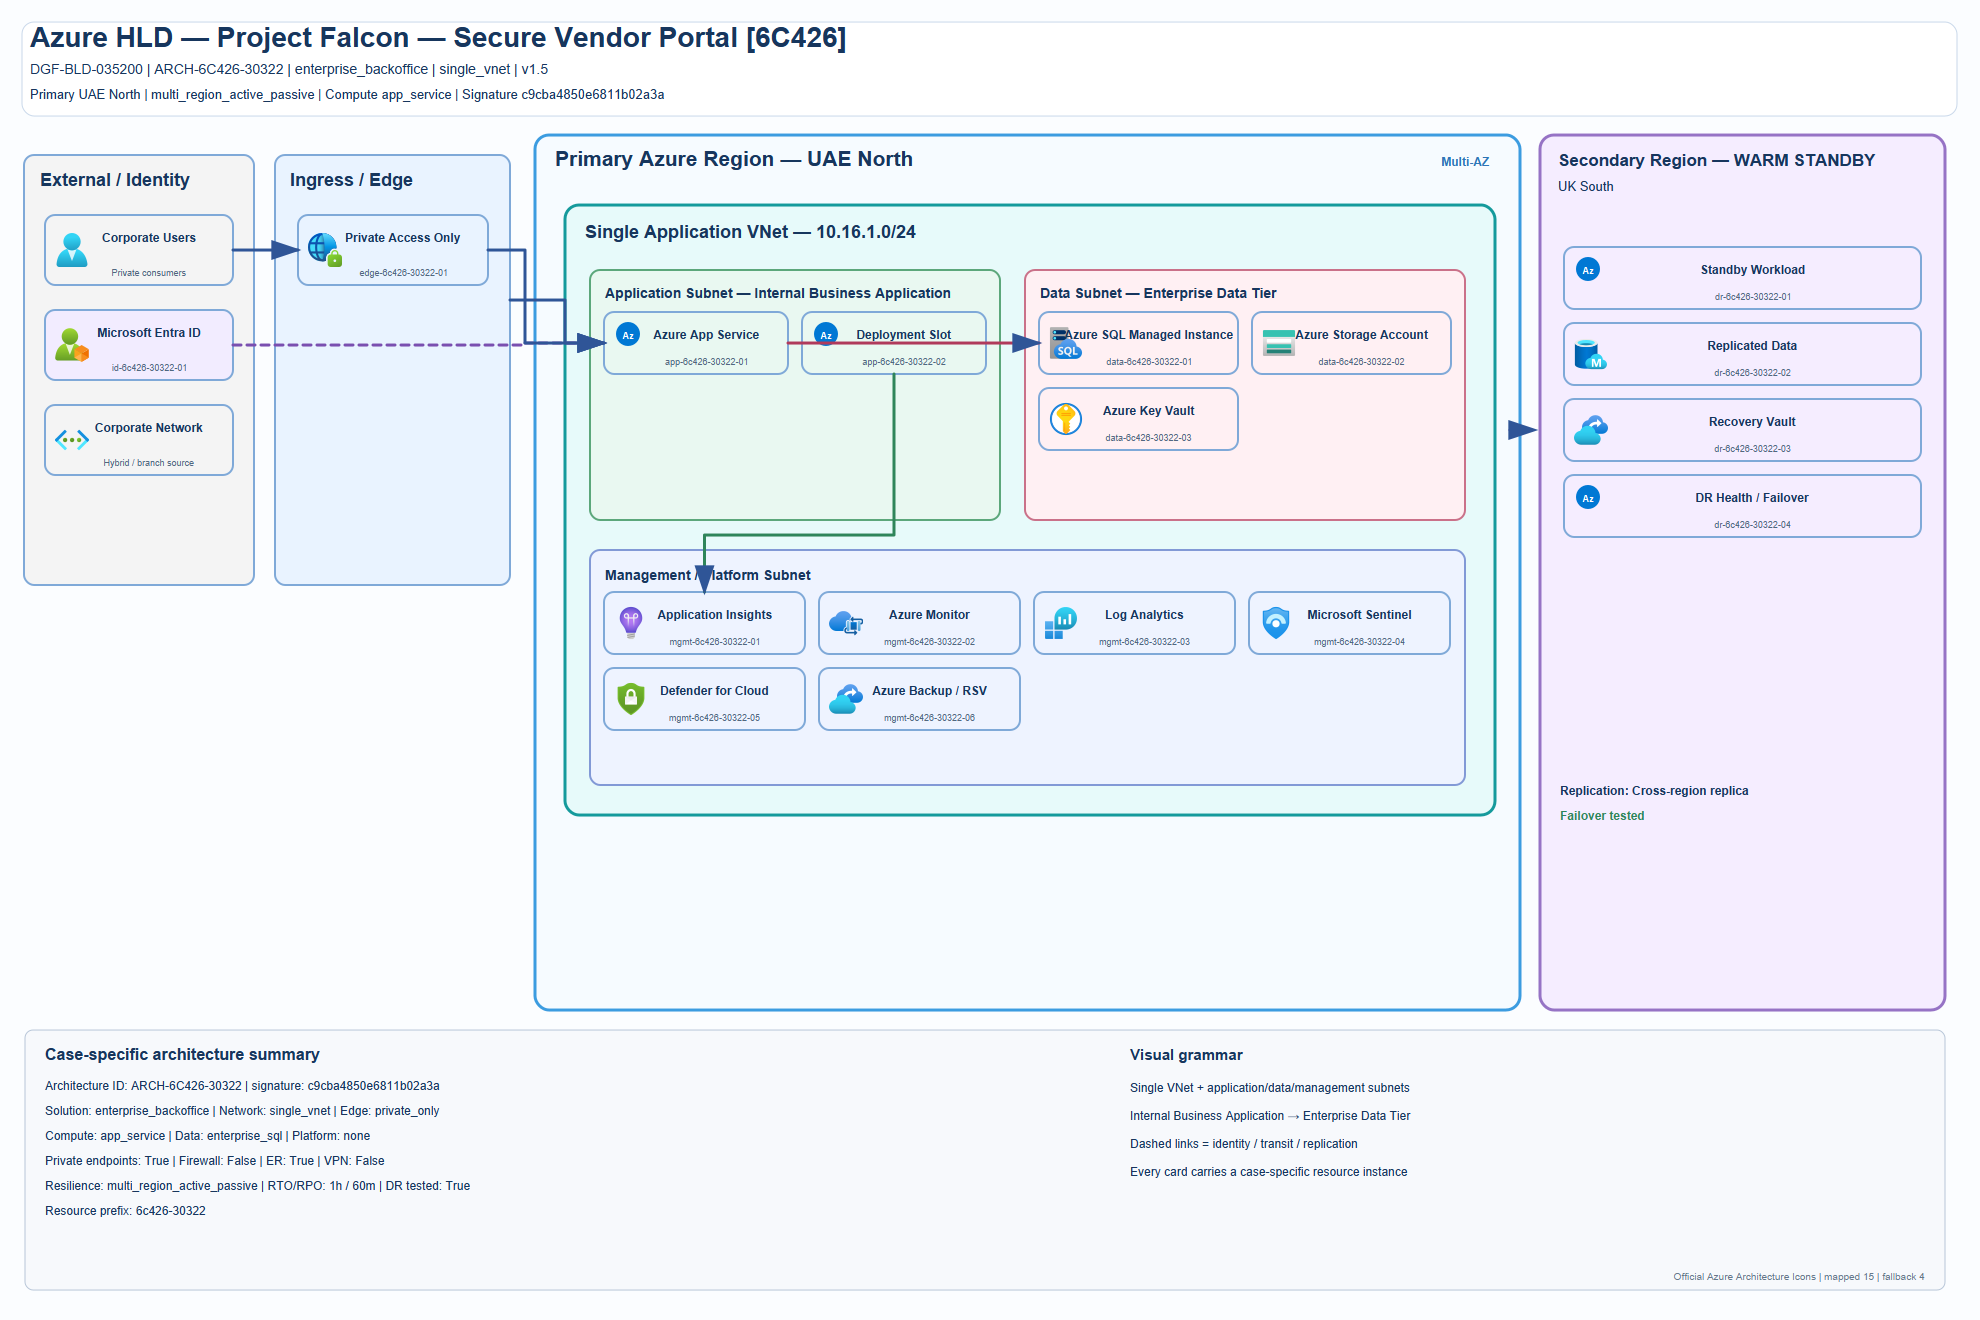
Un vrai document du jeu de tests : le schéma d'architecture du projet Falcon
Le même agent tourne avec trois modèles : Gemini 3.8 Flash, GPT-5.6 Luna et DeepSeek v4.1 Flash, sous les noms de points d'accès servis les 22 et 23 septembre 2026. Les réglages sont identiques : température à zéro, au plus 20 cycles de raisonnement et 40 appels d'outils par revue. Le plan prévoyait 1 700 revues par modèle, soit 900 parcours de projet complets. Un parcours a été perdu sur un incident technique chez le fournisseur du modèle ; les résultats principaux portent donc sur 899 parcours et 5 094 revues. Les appels aux modèles pour toute l'expérience ont coûté 99,58 $, tentatives échouées comprises. C'est le prix de l'expérience, pas celui de la construction ou de l'exploitation d'un tel système en entreprise.
C'est un programme qui décide si l'agent a réussi, pas un jury
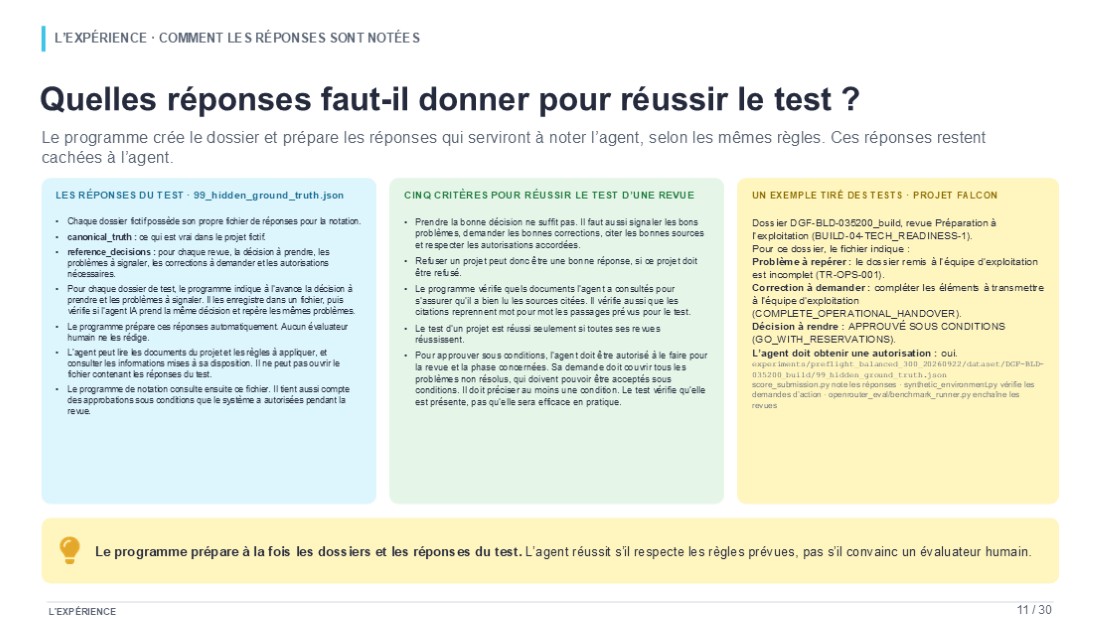
Quand le programme crée un projet, il en fixe les faits : contrat signé ou non, fournisseur contrôlé ou non, test obligatoire réussi ou manquant. De ces faits et de ses règles, il déduit la décision à prendre, les problèmes à signaler et les actions à demander, puis il enregistre ces réponses pour la notation. Aucun humain ne les écrit, et aucun humain ne juge la prose de l'agent.
Les réponses sont dans 99_hidden_ground_truth.json. Le champ canonical_truth contient les faits du projet fictif ; reference_decisions contient les réponses attendues pour chaque gate. L'agent ne peut pas lire ce fichier. Une fois le parcours terminé, le programme de notation compare les soumissions de l'agent à ce fichier, en tenant compte des approbations sous conditions correctement autorisées pendant l'exécution.
Chaque revue doit remplir cinq critères
- Décision. La décision prévue pour le cas.
- Problèmes. Tous les problèmes requis signalés, aucun ajouté.
- Actions. Les corrections nécessaires demandées.
- Sources. Des sources admises, avec les passages attendus cités mot pour mot.
- Autorisations. Une décision qui reste dans les droits accordés.
Pour les sources, la vérification va plus loin qu'une référence plausible. Le programme lit les journaux d'outils pour confirmer que l'agent a réellement ouvert les sources qu'il cite, puis vérifie que ses citations reproduisent mot pour mot les passages attendus. Une décision juste peut donc échouer parce que la citation qui la soutient n'atteint pas le niveau qu'un auditeur exigerait.
Les autorisations sont contrôlées à un autre moment. Quand l'agent demande une approbation sous conditions, l'outil vérifie que son mandat couvre cette gate et cette phase du projet, que tous les problèmes non résolus sont listés et qu'ils sont éligibles à une approbation sous conditions. Si l'un de ces points manque, la demande est refusée et le refus est enregistré.
L'agent peut exiger un test de restauration. Le benchmark ne restaure pas pour autant une sauvegarde quelque part. Il évalue la revue et la décision. Automatiser aussi la correction supposerait d'exécuter l'action autorisée, d'en enregistrer le résultat et de réexaminer le projet, ce qui est une tâche à part, avec son propre mandat.
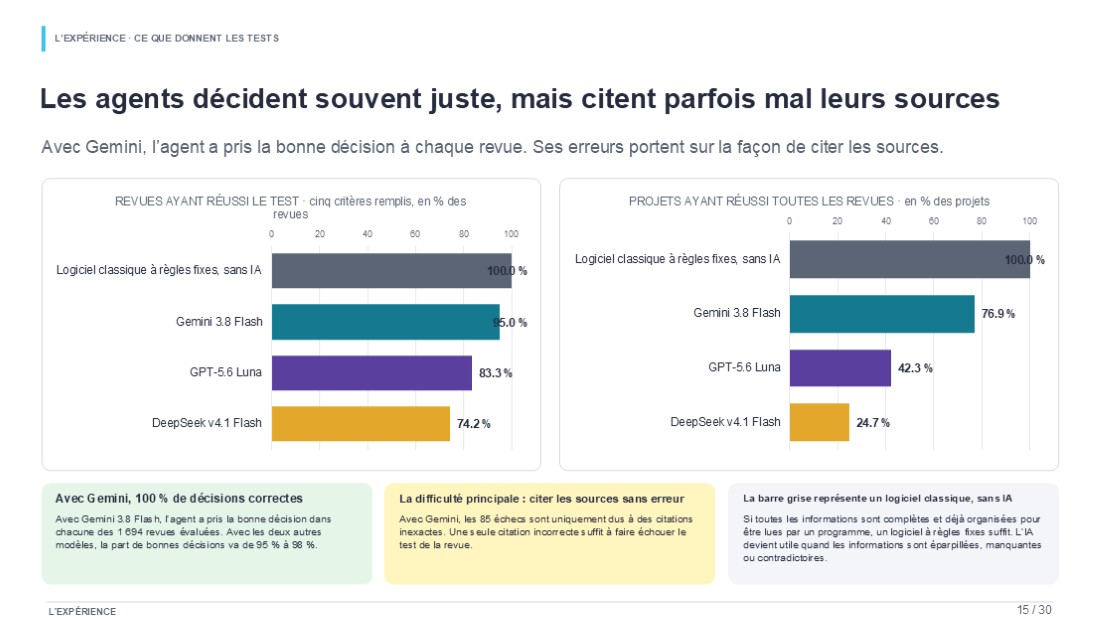
100 % de bonnes décisions, 95 % de revues complètes, 77 % de parcours complets
Avec Gemini, l'agent prend la bonne décision dans chacune des 1 694 revues évaluées. Pourtant, seules 94,98 % de ces revues remplissent les cinq critères, et seuls 76,92 % des projets réussissent toutes les gates de leur parcours. Ces trois nombres mesurent trois choses différentes, et il vous faut les trois avant de déléguer quoi que ce soit.
Le premier mesure la décision seule. Le deuxième exige une revue complète : bonne décision, constats complets, actions justes, sources exactes, mandat respecté. Le troisième exige que chaque gate du projet réussisse ; une seule revue échouée fait échouer le parcours. « 77 % de projets réussis » ne veut pas dire « 77 % de projets approuvés » : beaucoup ont été refusés à juste titre.
1 / Revues qui remplissent les cinq critères
2 / Projets dont toutes les revues réussissent
Avec GPT-5.6 Luna et DeepSeek v4.1 Flash, les taux stricts sont de 83,29 % et 74,18 %, et les parcours complets tombent à 42,33 % et 24,67 %. Leurs décisions sont justes dans environ 98 % et 95 % des revues. L'écart entre une décision juste et une revue complète, c'est là que se trouve le travail d'ingénierie.
Le point faible : la citation exacte des sources
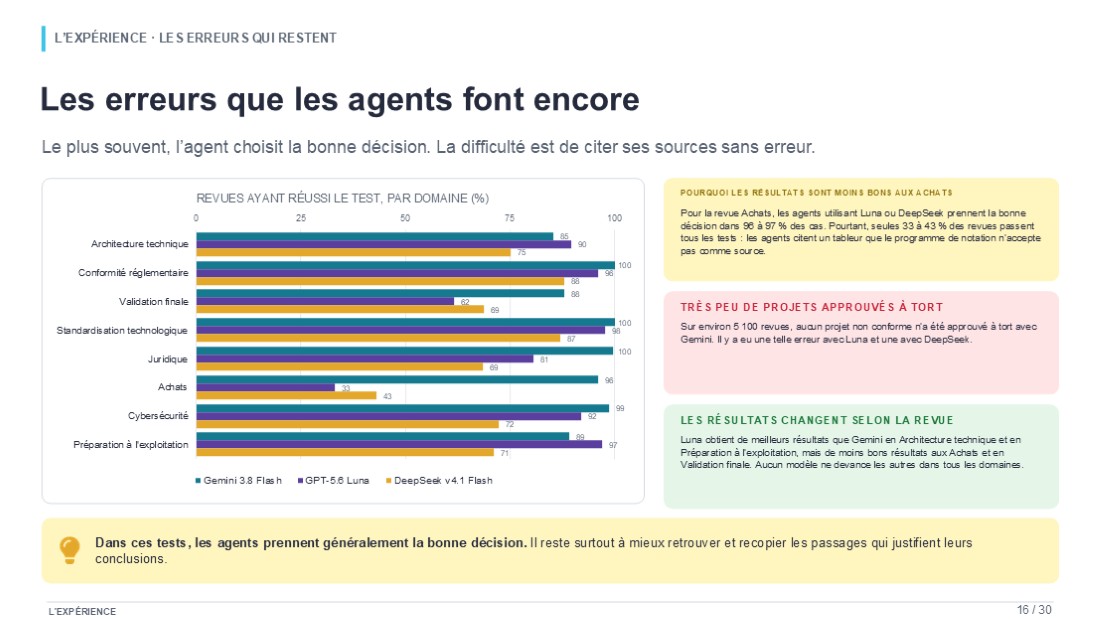
Les 85 revues échouées de Gemini échouent pour une seule raison : une source absente, ou une citation qui ne respecte pas l'exigence. Aux Achats, Luna et DeepSeek prennent la bonne décision dans 96 % et 97 % des revues mais ne remplissent tous les critères que dans 33 % et 43 % des cas, parce qu'ils citent un tableur que les règles de notation n'admettent pas comme source. La décision est juste ; la piste de preuves ne l'est pas.
Il y a aussi des erreurs de fond, et je les compte à part parce que ce sont celles qui comptent pour un RSSI. Luna approuve une revue Juridique malgré l'absence d'accord de traitement des données. DeepSeek soumet un GO par défaut là où un chevauchement de plages d'adresses impose un NO_GO. Gemini n'enregistre aucune approbation à tort dans les tests principaux. Sur environ 5 100 revues, cela fait une fausse approbation chacun pour Luna et DeepSeek, et zéro, trois et un problème grave manqué.
Les résultats changent selon le type de revue
| Revue | Gemini 3.8 Flash | GPT-5.6 Luna | DeepSeek v4.1 Flash |
|---|---|---|---|
| Architecture technique | 85,43 % | 89,50 % * | 75,00 % |
| Conformité réglementaire | 100,00 % * | 96,00 % | 88,00 % |
| Validation finale | 87,96 % * | 61,67 % | 68,67 % |
| Standardisation technologique | 100,00 % * | 97,67 % | 87,00 % |
| Juridique | 99,50 % * | 80,50 % | 68,50 % |
| Achats | 96,00 % * | 33,00 % | 43,00 % |
| Cybersécurité | 98,66 % * | 92,00 % | 72,33 % |
| Préparation à l’exploitation | 89,00 % | 97,00 % * | 71,00 % |
* Meilleur score de la ligne. Une cellule plus foncée indique un taux de réussite plus élevé.
Ce que vous apprend le programme sans IA
Le programme classique à règles fixes obtient 100 % sur les 1 700 revues et les 300 projets. C'est le nombre le plus utile du tableau pour qui prépare un déploiement. Quand les faits sont déjà structurés et les règles explicites, un logiciel ordinaire suffit, et il ne coûte rien à l'appel. L'agent gagne sa place là où les faits sont dispersés dans les documents, difficiles à retrouver ou contradictoires. Construisez d'abord le noyau déterministe, puis placez l'agent autour pour ce qui demande de lire et d'enquêter.
Un dernier résultat montre où se trouve le levier. Si la notation accepte les mêmes valeurs citées dans un ordre différent, 69 revues de plus réussissent pour Gemini, 38 pour Luna et 52 pour DeepSeek, et Gemini atteint 99,06 % des revues et 94,98 % des parcours complets. Rien n'a changé dans le jugement de l'agent. Ce qui a changé, c'est la façon de représenter les preuves. C'est un problème d'outillage, et les problèmes d'outillage se règlent en quelques semaines.
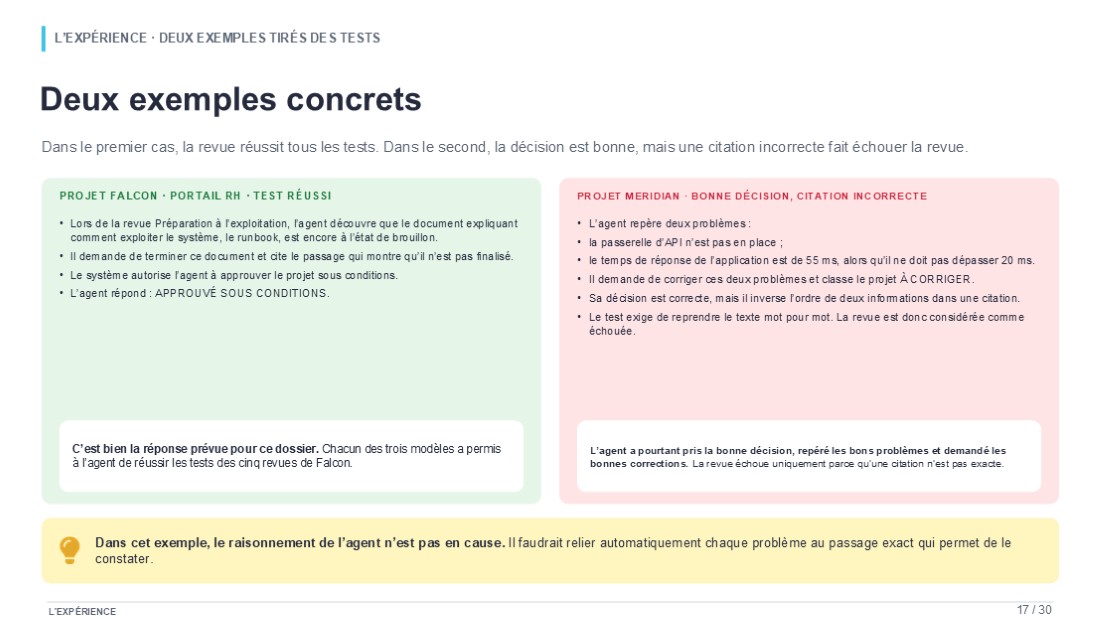
Falcon et Meridian : ce que l'agent fait vraiment à une gate
Deux dossiers tirés des journaux d'exécution montrent ce qu'il y a derrière les pourcentages. Je les ai choisis après l'évaluation pour illustrer le mécanisme : une réussite et un échec instructif.
La procédure d'exploitation est encore un brouillon
Falcon est un portail RH fictif pour 1 000 salariés, avec un budget de 500 000 EUR et des données confidentielles. Lors de la revue de préparation à l'exploitation, l'agent lit les documents d'exploitation et découvre que le runbook, le document qui explique comment faire fonctionner l'application, est encore marqué comme brouillon.
L'agent cite la ligne qui établit le problème, vérifie son mandat, demande une approbation sous conditions et l'obtient. La condition reste ouverte, avec un responsable désigné, et doit être remplie avant la mise en service. C'est exactement ce qu'on attend d'un bon relecteur humain. Avec chacun des trois modèles, les cinq revues de Falcon réussissent.
Les bons constats, une citation inexacte
L'agent trouve deux défauts : une passerelle d'API obligatoire manque, et le temps de réponse mesuré est de 55 millisecondes pour une cible de 20. Il demande les deux corrections et prend la bonne décision : À CORRIGER.
Décision, constats et corrections demandées sont tous justes. La revue obtient 0,95 avec une méthode pondérée et échoue avec la méthode stricte, parce que chaque critère doit passer. L'outil d'autorisation a fait son travail deux fois, en refusant des approbations auxquelles l'agent n'avait pas droit.
Meridian vous dit quoi construire. La correction n'est pas un modèle plus puissant. C'est un outil qui attache à chaque constat le passage exact de la source, avec son emplacement et sa version, pour que l'agent n'ait jamais à reconstituer une citation de mémoire. Un service de preuves de ce type supprime la première cause d'échec de ces tests.
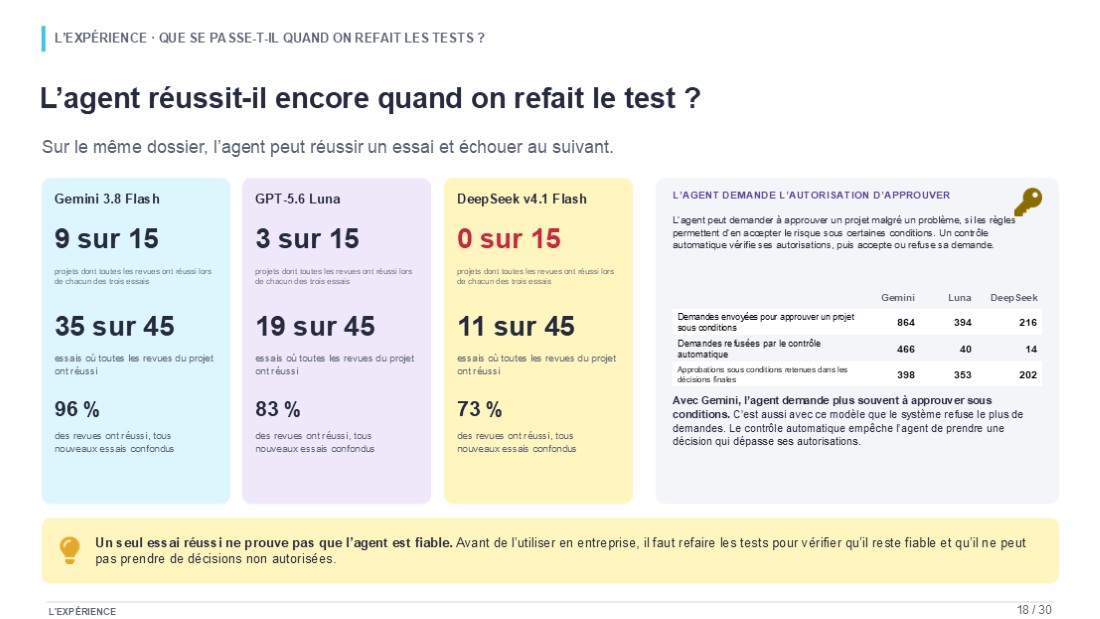
Le même dossier peut réussir un essai et échouer au suivant
Un score de benchmark, c'est un essai. Un déploiement, c'est des milliers d'essais. Après les tests principaux, j'ai repris 15 projets, cinq par parcours, et je les ai fait réviser trois fois de plus par chaque modèle : 135 parcours supplémentaires, sans garder le meilleur des trois. La question n'est plus de savoir si un projet a réussi, mais si toutes ses revues réussissent à chaque fois.
Réussir une fois, ce n'est pas réussir trois fois de suite
Gemini 3.8 Flash
9 sur 15projets dont toutes les revues réussissent à chacun des trois essais.
GPT-5.6 Luna
3 sur 15projets dont toutes les revues réussissent à chacun des trois essais.
DeepSeek v4.1 Flash
0 sur 15projets dont toutes les revues réussissent à chacun des trois essais.
Sur les 45 parcours répétés par modèle, toutes les revues réussissent 35 fois avec Gemini, 19 fois avec Luna et 11 fois avec DeepSeek. Les taux stricts par revue tiennent à 96,08 %, 82,75 % et 73,33 %. Aucune approbation à tort ni aucun problème grave manqué sur ces 135 parcours. Les répétitions ont coûté 12,56 $ d'appels aux modèles. La leçon pour un déploiement tient en une phrase : avant qu'un agent reprenne une gate, faites-lui repasser les mêmes dossiers plusieurs fois et regardez la dispersion, pas seulement la moyenne.
L'autorité ne peut pas reposer sur la seule parole du modèle
L'agent peut demander à l'outil d'autorisation la permission d'approuver sous conditions. L'outil enregistre trois choses : les demandes faites, les demandes refusées et les approbations réellement utilisées dans les décisions finales. Ce sont des nombres d'appels, pas de projets ; une gate peut produire plusieurs demandes.
| Demandes enregistrées dans les tests principaux | Gemini | Luna | DeepSeek |
|---|---|---|---|
| Demandes d’approbation sous conditions | 864 | 394 | 216 |
| Demandes refusées par le contrôle | 466 | 40 | 14 |
| Approbations utilisées dans les décisions finales | 398 | 353 | 202 |
Demandes enregistrées dans les tests principaux. Les mêmes 391 gates éligibles sont offertes à chaque modèle.
Gemini demande le plus souvent et se fait refuser le plus souvent : 466 de ses 864 demandes. Un agent cherchera des approbations que les règles n'autorisent pas, parfois avec insistance. Ce qui l'arrête, c'est le contrôle d'autorisation séparé, pas une promesse écrite dans sa réponse. S'il n'y a qu'une règle d'architecture à retenir de cet article, c'est celle-là : le composant qui accorde l'autorité ne doit pas être celui qui raisonne.
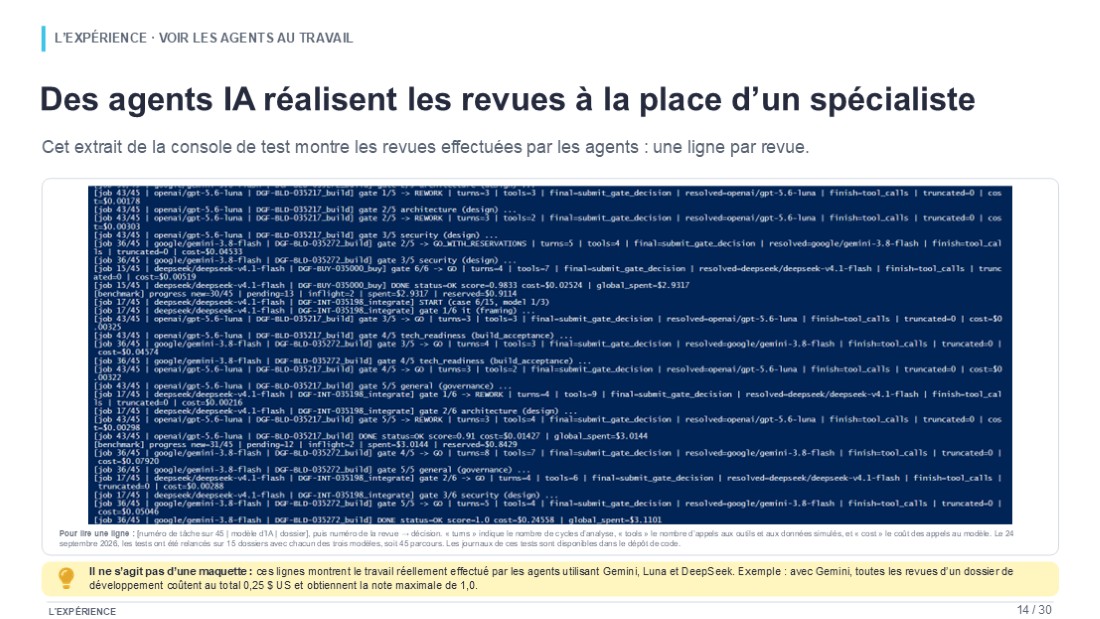
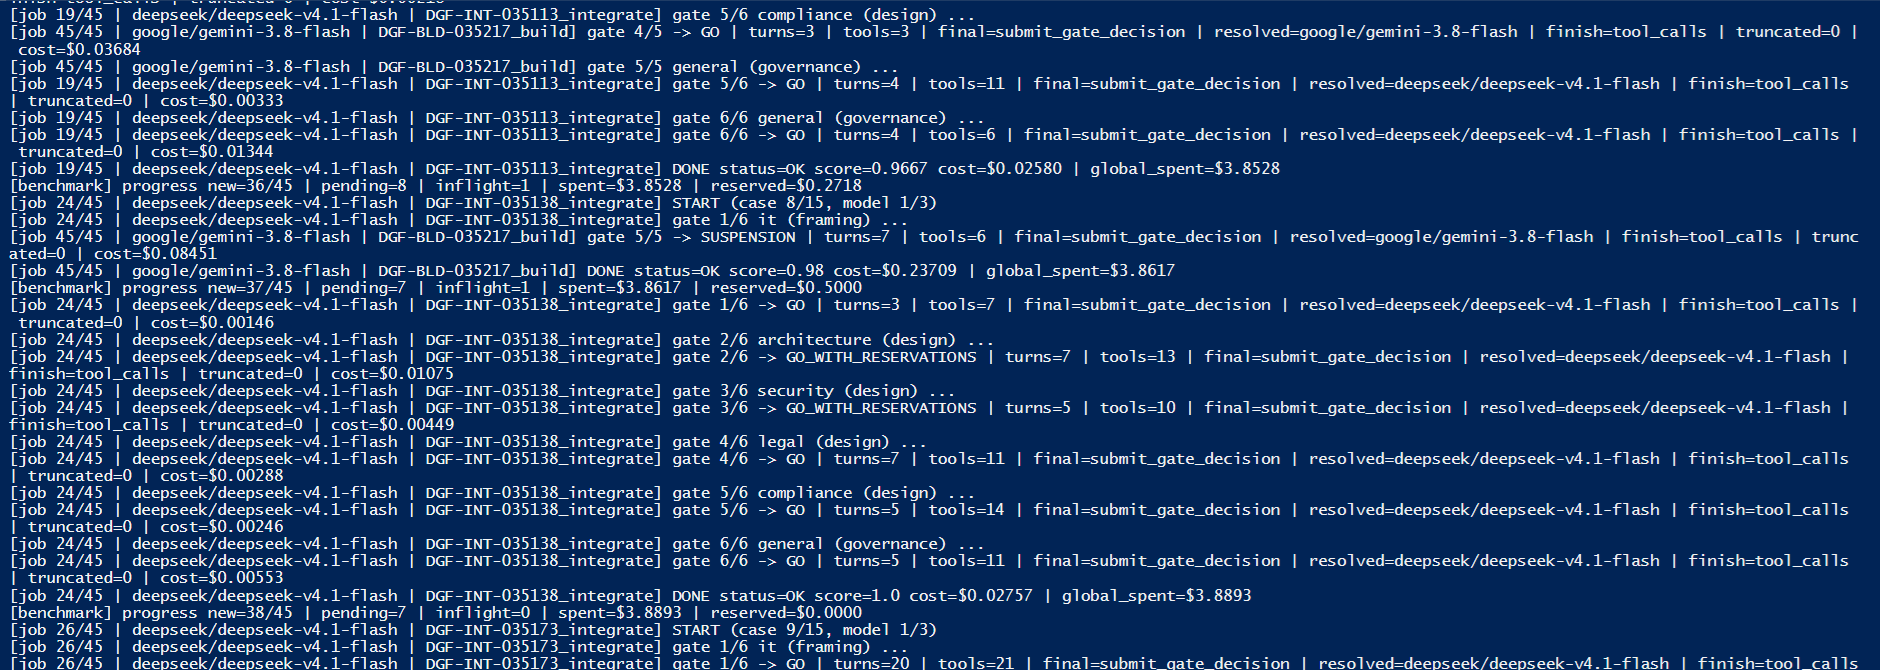
Journaux d'exécution de la console du benchmark
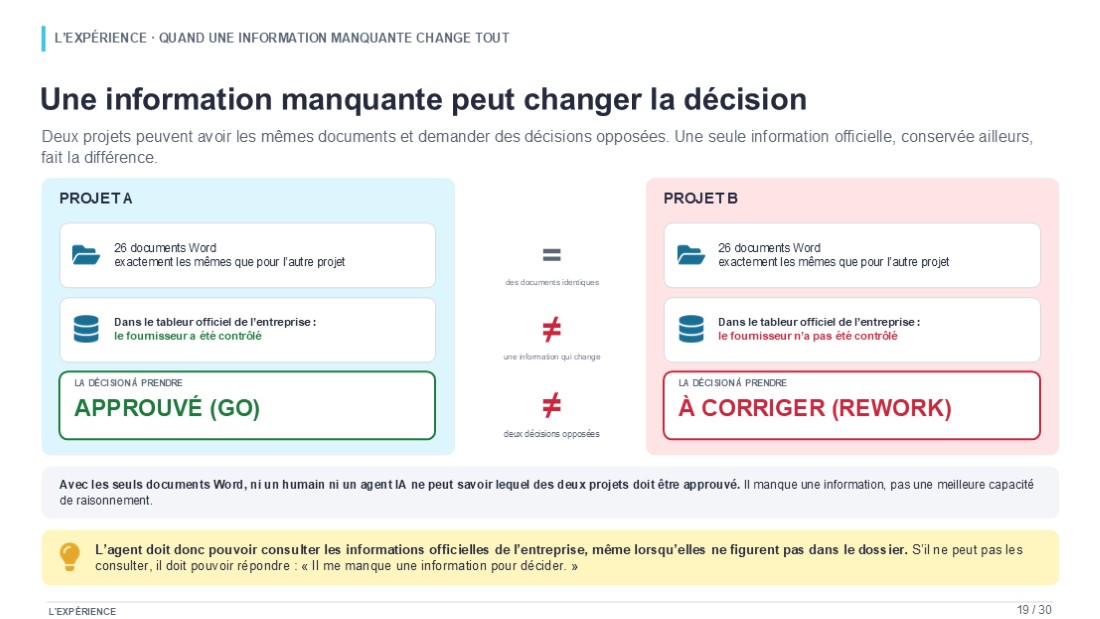
Mieux raisonner ne permet pas de retrouver un fait qu'on ne vous a jamais donné
Prenez deux projets dont les 26 documents Word sont strictement identiques. La décision attendue est pourtant différente, parce que la différence se trouve dans un registre séparé : dans un projet, le fournisseur a passé son contrôle de réputation ; dans l'autre, non.
Les mêmes documents, un fait différent, une décision différente
PROJET A
Dans le fichier CSV de référence :
le contrôle du fournisseur est terminé.
PROJET B
Dans le fichier CSV de référence :
le contrôle du fournisseur n’a pas été réalisé.
Cette limite vaut pour une personne autant que pour un agent. Le raisonnement ne fabrique pas un fait que personne n'a donné au relecteur. Donner à l'agent l'accès au registre CSV, ou lui permettre de déposer une demande justifiée d'information manquante, change la tâche et la rend soluble.
C'est le premier travail du FDE, avant tout prompt : brancher l'agent sur les registres qui font foi, décider ce qu'il a le droit de lire, et préciser ce qu'il doit faire quand un fait manque. Dans mon cadre, l'accès à l'information est une condition de validité de la revue, pas un détail à régler après le choix du modèle. Un déploiement qui ne donne à l'agent que les PDF laisse de côté une information qu'un test équitable comme une exploitation sûre exigent.
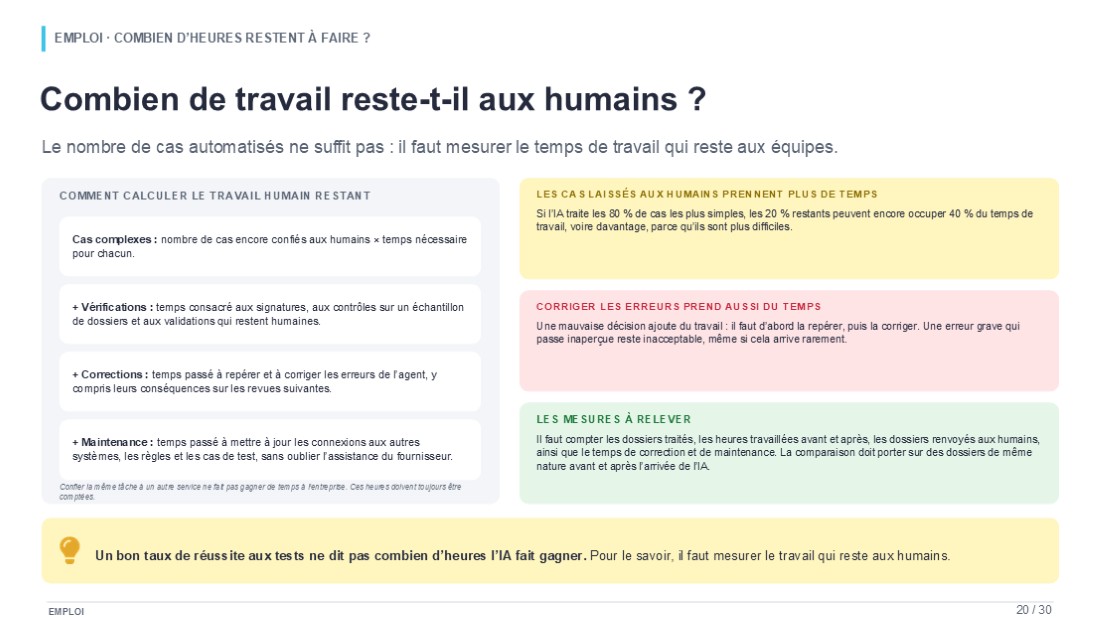
Automatiser 80 % des dossiers ne supprime pas 80 % du travail
Un taux de réussite ne mesure pas des heures économisées. Un agent peut reprendre la plupart des dossiers simples et laisser aux spécialistes exactement les cas qui prennent le plus de temps. Les vérifications humaines, la correction des erreurs et l'exploitation de la plateforme ajoutent ensuite leurs propres heures. Pour savoir ce que vous avez réellement économisé, il faut additionner tout ce qui reste.
Le travail humain à compter après l'automatisation
Les dossiers encore traités par des personnes
Leur nombre multiplié par le temps réel de chacun, qui peut être plus long qu'avant.
Les vérifications
Signatures, contrôles par échantillon et secondes lectures qui restent nécessaires.
La correction des erreurs
Trouver et réparer les erreurs, y compris leurs effets sur les revues en aval.
La maintenance et le support
Connexions, règles, cas de test, supervision et assistance des fournisseurs.
Voici le calcul qui surprend le plus. Supposons que l'agent traite les 80 % de dossiers les plus simples. Chaque dossier restant prend deux fois le temps moyen initial : les 20 % restants représentent déjà 40 % de la charge de départ. Si la nouvelle répartition du travail rallonge encore ces dossiers de 50 %, parce qu'un spécialiste doit maintenant reprendre un dossier à froid, ils représentent à eux seuls 60 % de la charge de départ. Et la maintenance n'est pas encore comptée.
La qualité joue de la même façon. Une erreur qui passe inaperçue au départ crée du travail plus tard : quelqu'un doit la retrouver, en comprendre les conséquences et la corriger. Et une erreur dangereuse laissée sans correction ne devient pas acceptable parce que le système coûte peu à faire tourner.
La formule que j'utilise pour compter le travail restant
λ est le nombre de dossiers sur la période ; q la part encore traitée par des personnes ; hE le temps humain par dossier restant ; hR le temps de vérification sur les autres dossiers ; hW le temps moyen de correction par dossier ; et BA le travail de maintenance et de support sur la période. L'idée est d'additionner des heures réelles au lieu de les déduire du pourcentage de dossiers automatisés.
Pour mesurer une réduction dans votre propre organisation, suivez les mêmes types de dossiers avant et après l'automatisation : temps de traitement, dossiers renvoyés à des personnes, corrections et support. Gardez des identifiants de dossier constants pour ne jamais compter deux fois la même tâche ni en oublier une.
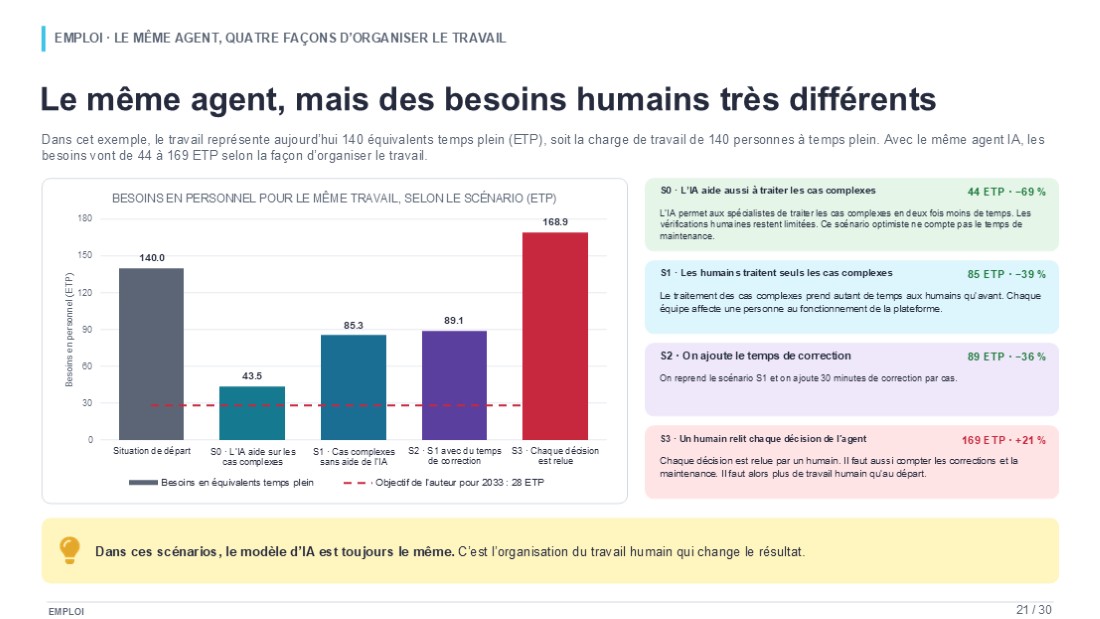
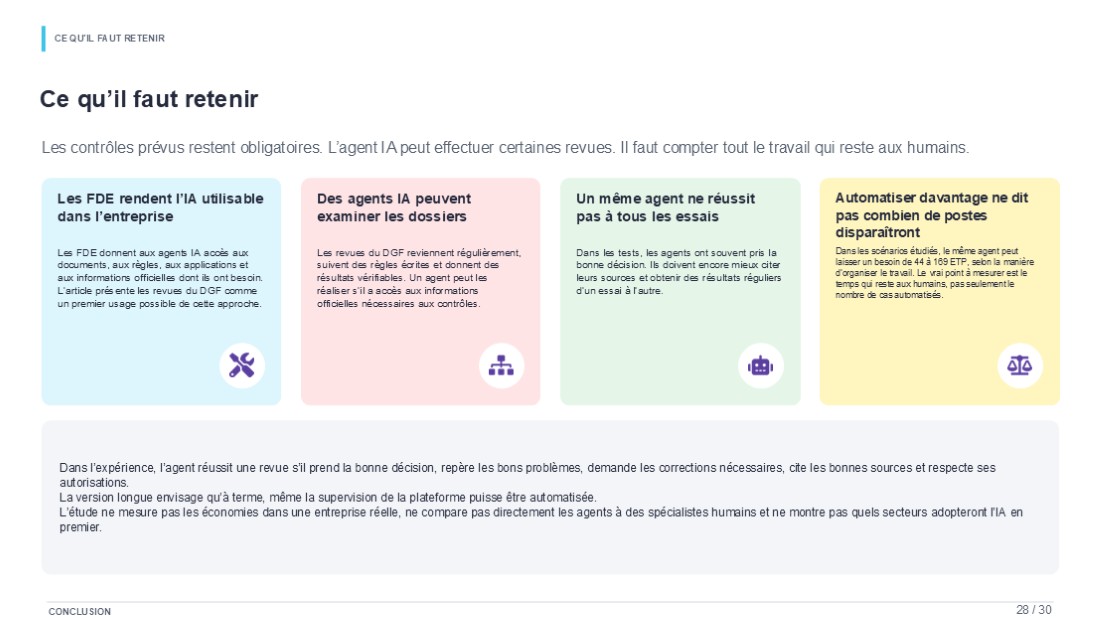
La même automatisation peut laisser un besoin de 44 ou de 169 ETP
Prenez une fonction de gouvernance qui occupe aujourd'hui 140 équivalents temps plein. Un ETP est une quantité de travail, pas une personne en particulier. Les quatre scénarios ci-dessous gardent la même part de dossiers automatisés et ne changent que l'organisation du travail restant. L'écart entre eux est tout le sujet.
Besoins humains pour le même périmètre de travail · ETP
S0 : l'IA aide aussi sur les cas complexes. Les spécialistes les traitent en deux fois moins de temps, et les autres dossiers ne reçoivent que des vérifications limitées. Résultat : 43,52 ETP, soit environ 69 % de moins. C'est le scénario le plus optimiste, et il ne compte aucune maintenance.
S1 : les cas difficiles prennent autant de temps qu'avant. Les spécialistes les traitent sans aide de l'IA, les autres dossiers reçoivent de brèves vérifications, et chaque équipe affecte une personne au fonctionnement de la plateforme. Le besoin monte à 85,32 ETP. S2 reprend ces hypothèses et ajoute une demi-heure de correction par dossier : 89,07 ETP.
S3 : des personnes relisent chaque décision. Les cas complexes prennent 50 % de temps en plus, les vérifications sont étendues, les corrections prennent deux heures par dossier et deux personnes par équipe font tourner la plateforme. Le besoin atteint 168,92 ETP, soit environ 21 % de travail humain en plus qu'avant l'automatisation. Une organisation qui ne fait confiance à rien de ce que l'agent produit finit par payer l'agent et les relecteurs.
La part de dossiers automatisés n'est pas le chiffre qui compte. Ce qui compte, c'est le temps que l'organisation continue de demander aux gens.
Avant de promettre un chiffre d'effectifs, décidez quel scénario vous construisez réellement : qui traite les exceptions, avec quelle aide, quelle part de vérification vous conservez, et qui fait tourner la plateforme. Le même modèle donne 44 ou 169 selon ces quatre réponses.
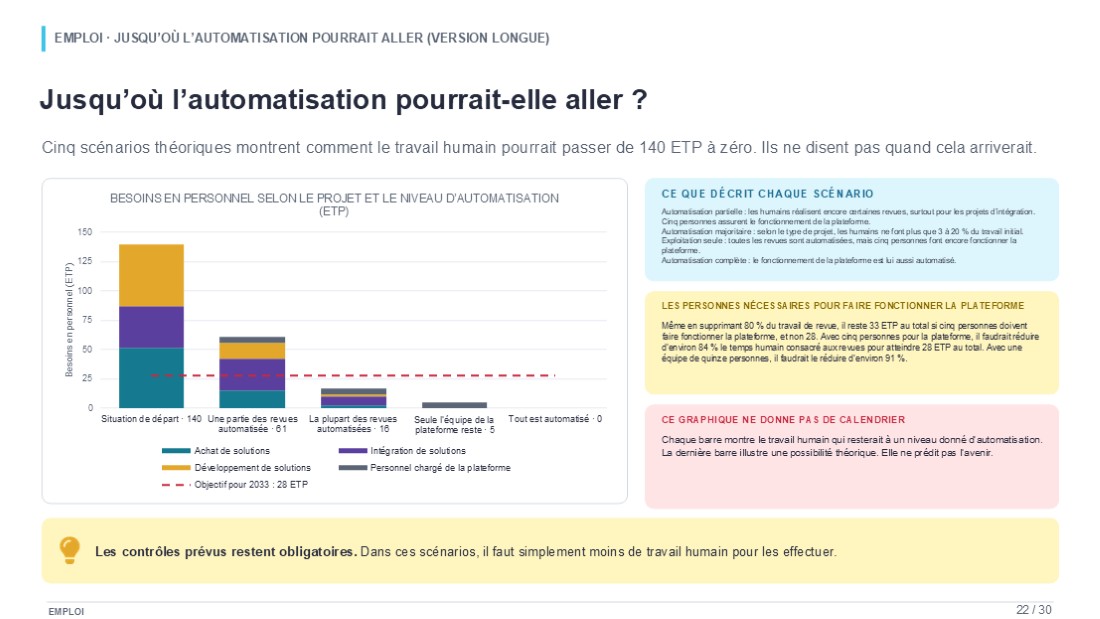
Jusqu'où l'automatisation peut aller, et à quel horizon
Le benchmark s'arrête à la revue. La version longue de mon travail pousse l'hypothèse jusqu'au bout : à terme, des agents réalisent toutes les revues, y compris les cas complexes et la décision finale, puis le travail de supervision, de maintenance des règles et de traitement des exceptions est automatisé à son tour. Voici ce chemin pour la même fonction de 140 ETP.
Cinq niveaux d'automatisation, pas cinq dates · ETP
Les contrôles ne disparaissent jamais dans ces scénarios. Ce qui diminue, c'est le travail humain nécessaire pour les exécuter. La dernière marche, d'une petite équipe de support à zéro, est la plus dure : tant qu'une équipe fait tourner les agents, elle fixe un plancher d'effectifs.
Ce plancher est facile à sous-estimer. À partir de 140 ETP, automatiser 80 % du travail de revue laisse 28 ETP de revue. Ajoutez cinq ETP pour exploiter la plateforme et le total est de 33, pas 28. Pour arriver à 28 au total, il faut automatiser environ 84 % du travail de revue avec une équipe de support de cinq personnes, ou environ 91 % avec une équipe de quinze. Chaque ETP ajouté au support doit être regagné sur le travail de revue.
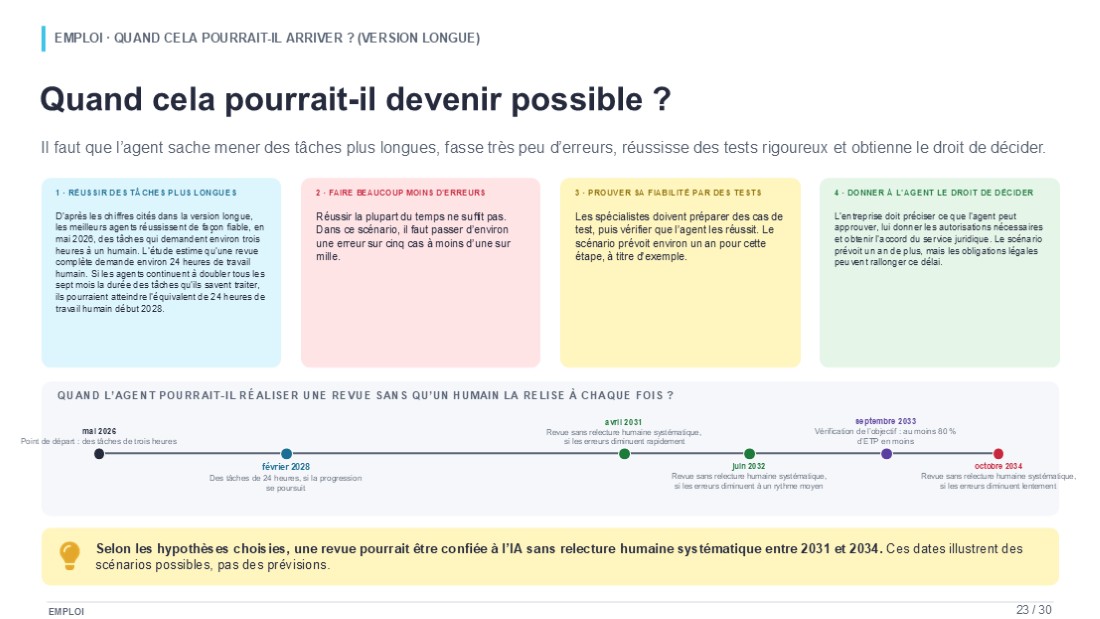
Un calendrier construit sur des hypothèses explicites
Quand une revue entière pourrait-elle être déléguée ? J'ai construit l'estimation en quatre étapes, chacune avec son hypothèse. Elle part d'une mesure de mai 2026 : les meilleurs agents réussissent des tâches valant environ trois heures de travail humain dans 80 % des cas, et cette durée double tous les sept mois. Une revue de gate typique représente environ 24 heures de travail humain, soit trois doublements, ce qui mène à février 2028.
La capacité ne suffit pas. Le taux d'erreur doit ensuite passer de 20 % à environ une défaillance sur mille, puis il faut une année de tests avec des spécialistes et une autre pour que l'entreprise accorde l'autorité. L'inconnue est le temps nécessaire pour diviser le taux d'erreur par dix : six, douze ou vingt-quatre mois.
Des dates illustratives, pas un calendrier de déploiement
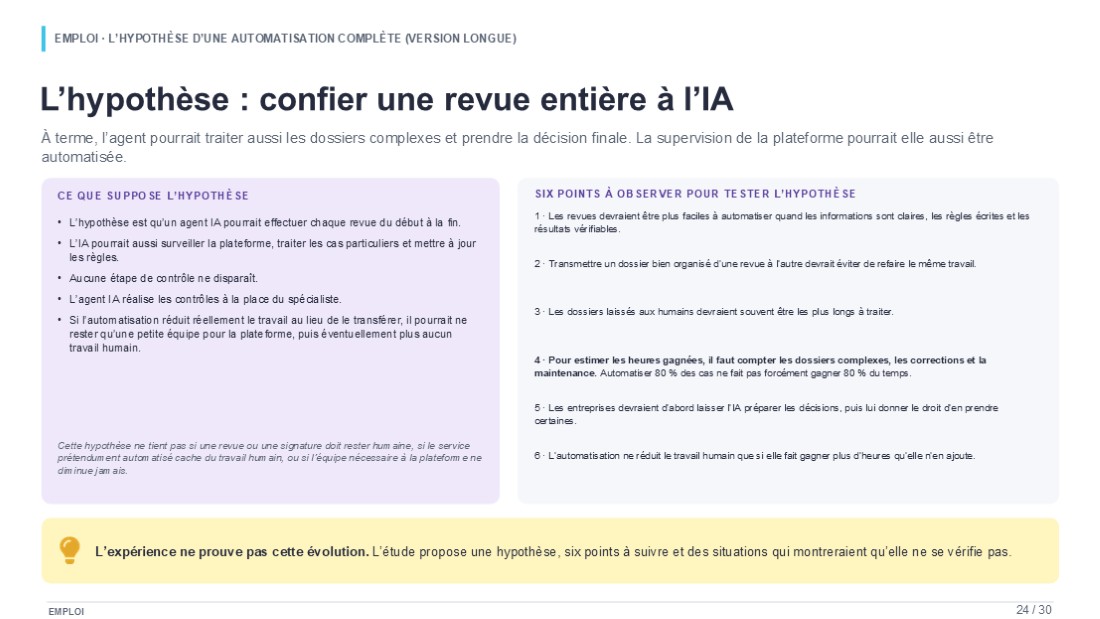
Six prédictions à confronter à vos propres données
Les revues bien définies s'automatisent en premier
Des entrées claires, des règles écrites et des résultats testables améliorent la fiabilité, quel que soit le modèle.
Une fiche de revue commune réduit le travail en double
Transmettre les constats et les sources réduit les reprises, et les agents produisent cette fiche à peu de frais.
Les dossiers laissés aux personnes prennent plus de temps
Leur part dans les heures dépasse leur part dans le nombre de dossiers.
Compter tout le travail restant prédit mieux
Cas complexes, corrections et support prévoient les heures restantes mieux qu'un pourcentage d'automatisation.
Préparer les décisions vient avant les approuver
Les entreprises laissent l'IA préparer les décisions avant de lui déléguer les droits correspondants.
Les tâches réservées aux humains se raréfient
Les tâches qui exigent des personnes aujourd'hui deviennent automatisables plus vite que de nouvelles tâches humaines n'apparaissent.
L'hypothèse échoue si une revue reste par nature humaine, si une signature humaine reste obligatoire, si un service « automatisé » tourne en réalité sur du travail humain caché, ou si l'équipe de support ne peut jamais être réduite. Chacun de ces points s'observe dans un déploiement réel, et c'est pour cela que je les ai mis sur la liste.
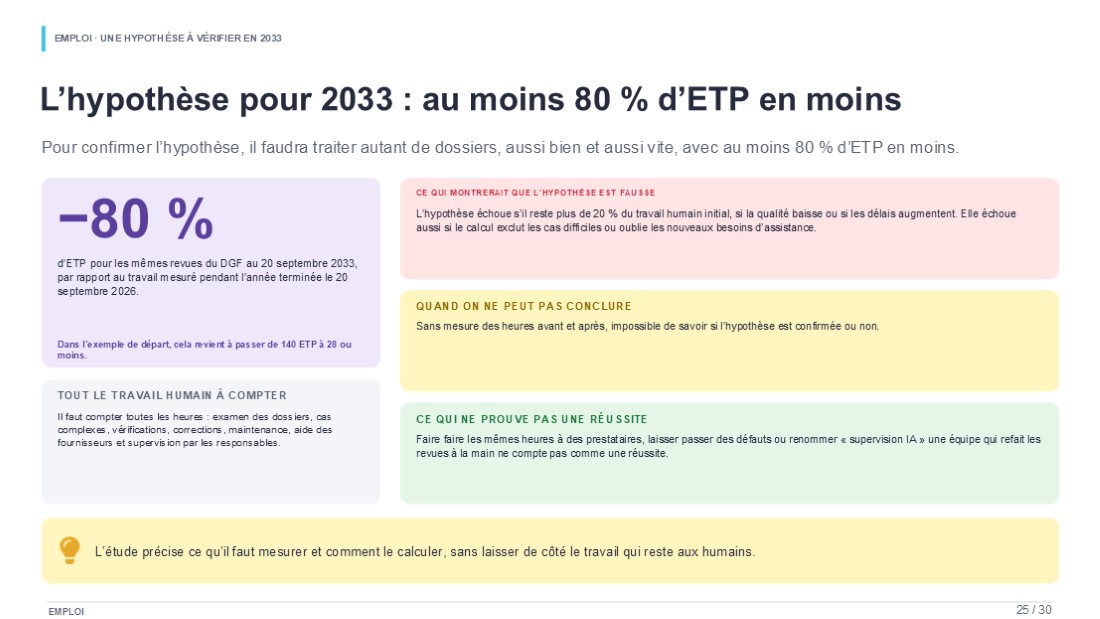
Ma prédiction : au moins 80 % d'ETP en moins en 2033
au 20 septembre 2033
Pour les mêmes revues du DGF, à charge comparable, avec la même qualité et les mêmes délais, par rapport à l'année de référence close le 20 septembre 2026.
Dans l'exemple à 140 ETP, cela signifie 28 ETP ou moins, tout le travail humain compris.
Je ne tire pas ce chiffre du taux de réussite de Gemini. C'est une prédiction à part, avec des conditions explicites. Le compte inclut tous ceux qui contribuent aux revues : les personnes qui les préparent et les réalisent, traitent les cas complexes, vérifient les résultats, corrigent les erreurs, maintiennent et supervisent les agents, et assistent les fournisseurs.
La prédiction échoue s'il reste plus de 20 % du travail humain initial, si la qualité baisse ou si les revues prennent plus de temps. Elle échoue aussi si la comparaison écarte les unités les plus difficiles, oublie les nouvelles fonctions de support ou décale l'échéance. Moins de salariés avec des prestataires qui font les mêmes heures ne compte pas. Des approbations plus rapides avec davantage de défauts qui passent ne comptent pas. Un service renommé « supervision de l'IA » dont le personnel fait toujours les revues à la main ne compte pas.
Pour tester la prédiction, il faut des relevés de temps auditables avant et après. Aucune entreprise n'est encore inscrite, et l'année de référence est déjà close. Une entreprise qui commence à mesurer maintenant lance un nouveau test de sept ans sur sa propre référence ; elle ne déplace pas l'échéance de 2033.
Ce que cela change pour les personnes qui font ce travail aujourd'hui
Dans la répartition que je propose, les personnes gardent la définition des règles, les décisions qui n'ont pas été déléguées, les signatures exigées par la loi ou par l'entreprise, les contrôles par échantillon et l'exploitation du système. Elles réalisent aussi les corrections demandées par les revues, tant que ces actions ne sont pas automatisées à leur tour. Les spécialistes passent moins de temps sur chaque dossier et davantage à concevoir, tester et maintenir les règles de décision.
Cela ne garantit ni que chaque poste survive, ni que chaque poste disparaisse. Une vraie baisse des heures nécessaires peut supprimer des postes ; une entreprise peut aussi garder la même équipe et traiter davantage de projets avec elle. Renommer les gens « superviseurs IA » ne change rien au calcul. Ce qui se mesure, c'est le travail, quel que soit l'intitulé du poste.
La même logique s'applique-t-elle à l'assurance ou à la banque ?
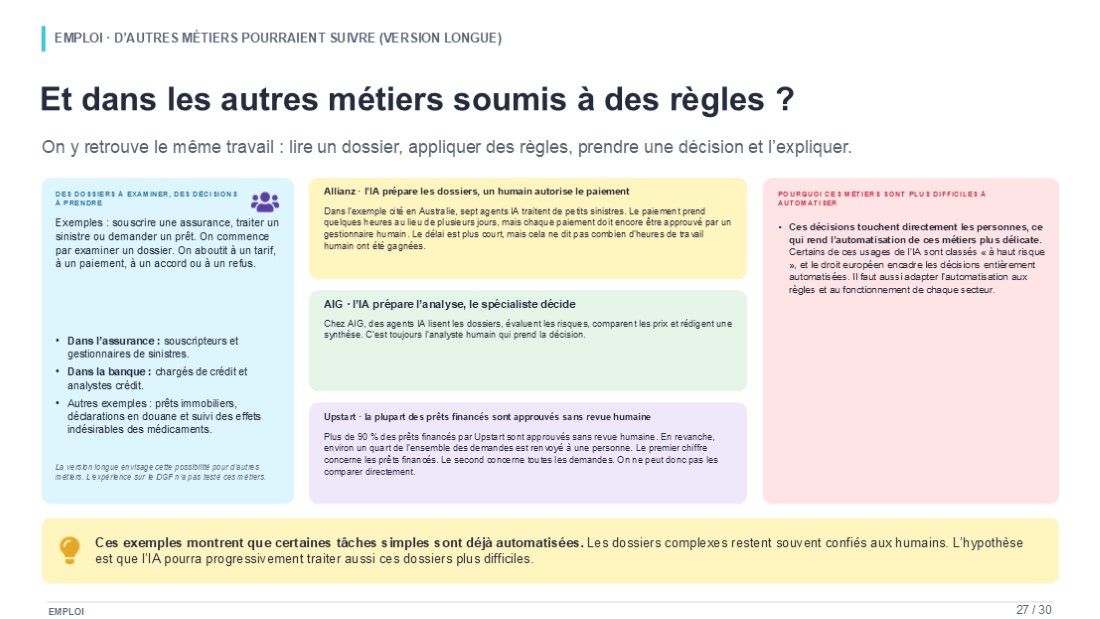
La structure est la même : examiner un dossier, appliquer des règles, décider, expliquer. La souscription, la gestion des sinistres et l'analyse de crédit y entrent toutes. DGF-Bench n'a pas testé ces métiers ; je donne donc trois exemples externes. Chez Allianz, des agents traitent les petits sinistres pendant qu'une personne autorise le paiement. Chez AIG, ils préparent l'analyse et un souscripteur décide. Chez Upstart, plus de 90 % des prêts financés sont approuvés sans relecture humaine, tandis qu'environ un quart de l'ensemble des demandes est renvoyé à une personne ; prêts financés et demandes totales sont deux dénominateurs différents.
Les règles sectorielles et les décisions qui touchent directement des personnes appellent leur propre cadre d'évaluation. Un délai plus court, un taux élevé d'approbation automatique et moins d'heures humaines sont trois choses différentes, et aucune ne remplace les deux autres.
Cinq décisions avant de déléguer une gate
Les agents ont réalisé 5 094 revues notées sur 899 parcours de projet. Le meilleur modèle a pris toutes ses décisions correctement, la plupart de ses revues ont rempli les cinq critères, et sa principale faiblesse, la piste de preuves, est un problème d'outillage. Les répétitions ont montré une dispersion qu'il faut mesurer, et l'outil d'autorisation a refusé des centaines d'approbations auxquelles l'agent n'avait pas droit. Tout le reste de cet article découle de ces faits. Voici ce que j'en ferais.
- Écrivez le contrat de la gate avant d'écrire un prompt. Nommez les entrées que le relecteur peut utiliser, la version de la politique, le mandat, les cinq sorties attendues et la population de dossiers, cas difficiles et refus légitimes compris.
- Branchez les registres qui font foi. Le projet A et le projet B diffèrent par un champ de CSV. Si l'agent ne peut ni le lire ni le demander, aucun modèle ne vous sauvera. Décidez ce qu'il peut lire et ce qu'il doit faire quand un fait manque.
- Gardez l'autorité hors du modèle. L'agent propose ; un contrôle déterministe accorde ou refuse ; le refus est journalisé. Gemini a demandé 864 fois et s'est vu refuser 466 fois. Ce refus est le mécanisme de sécurité.
- Attachez les preuves par un outil, pas par une citation. Meridian a échoué sur l'ordre de deux champs dans une citation. Un service de preuves qui copie la valeur source et son emplacement supprime la première cause d'échec.
- Comptez des heures, pas des dossiers. Suivez les mêmes dossiers avant et après, exceptions, vérifications, corrections et support de la plateforme compris. Décidez lequel des quatre scénarios d'effectifs vous construisez, puis annoncez un chiffre.
Commencez par les revues dont les règles sont déjà écrites et dont les faits sont déjà structurés, mettez un moteur de règles classique en leur cœur, et laissez l'agent lire, enquêter et proposer autour. Faites repasser les mêmes dossiers plusieurs fois avant de croire la moyenne. Puis mesurez les heures. C'est la séquence qui transforme un score de benchmark en une fonction de gouvernance qui coûte moins cher à faire tourner et qui tient toujours.
La revue reste obligatoire. Les questions sont de savoir qui l'exécute, avec quelles informations, avec quelles décisions permises, et combien de travail elle laisse à tous les autres.
Lire l'article, refaire le benchmark
Chaque chiffre de cet article peut être recalculé à partir des dossiers, des traces et du code de notation publiés, sans nouvel appel payant aux modèles. Les modèles sont désignés par leurs identifiants de points d'accès tels que servis du 22 au 24 septembre 2026. Les scénarios en ETP et la prédiction pour 2033 sont des hypothèses déclarées et une prévision datée, à confronter à des relevés d'heures.